
برنامهریزی اسپرینت با کمک هوش مصنوعی: چگونه آمادهسازی را سرعت ببخشیم بدون از دست دادن مسئولیتپذیری
بررسی عملی اینکه چگونه هوش مصنوعی برنامهریزی اسپرینت را تغییر میدهد: کجا آمادهسازی را سرعت میبخشد، چرا مسئولیت تیم را برنمیدارد و چگونه یک برنامه زیبا را با یک برنامه واقعگرایانه اشتباه نگیریم.
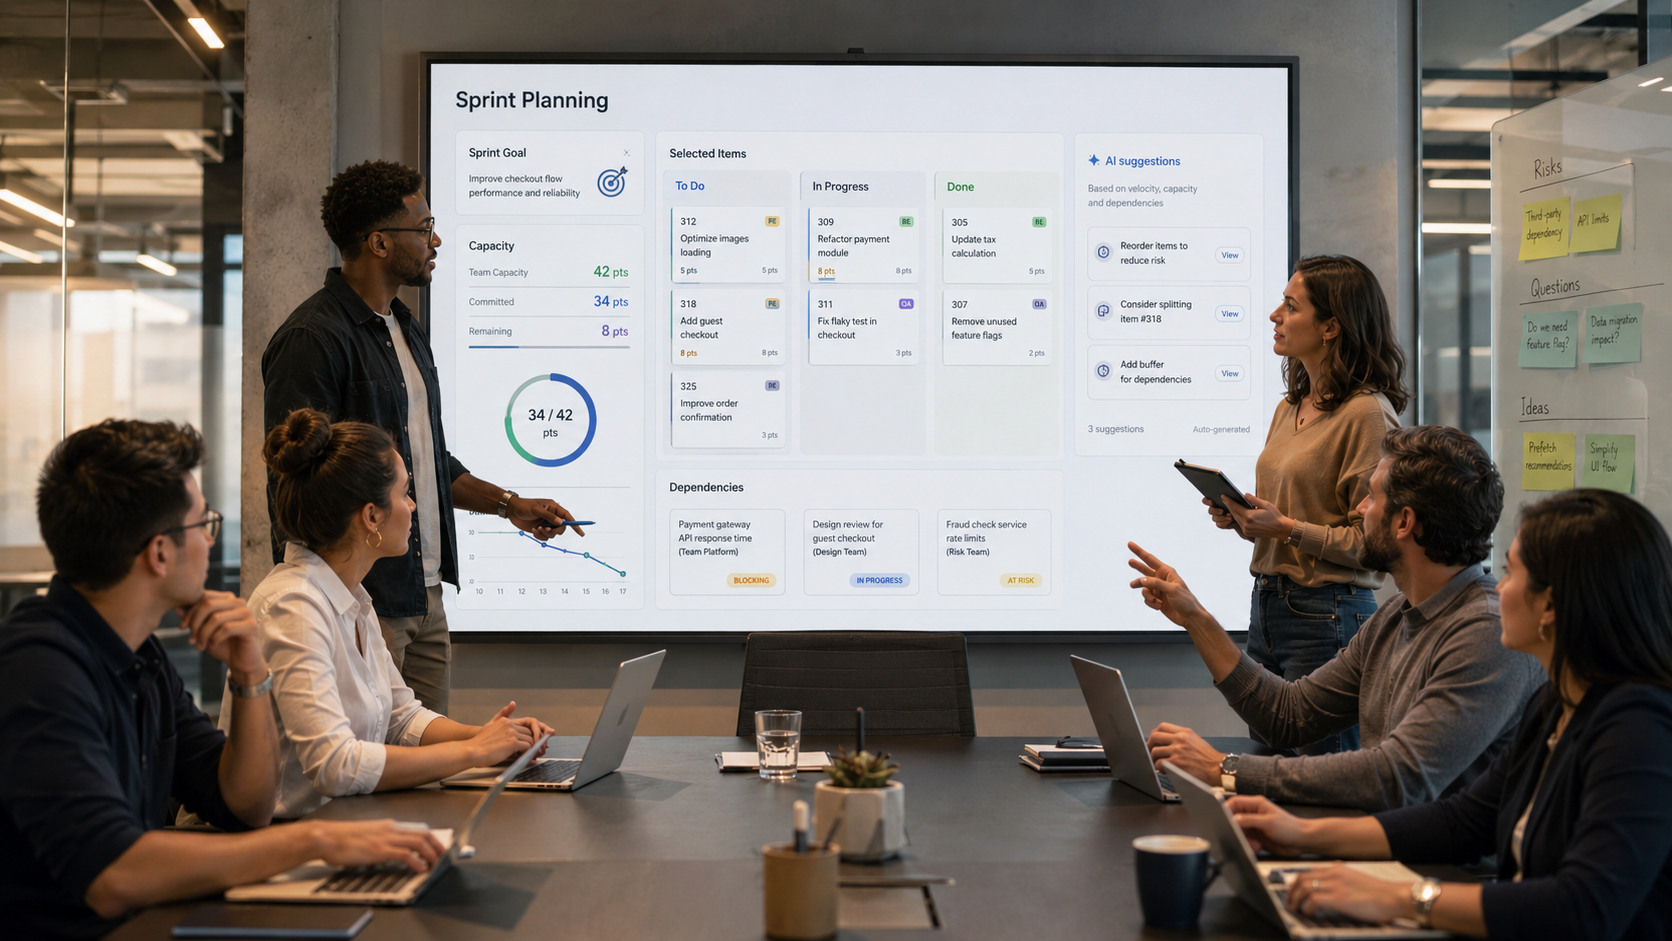 این تصویر بارگذاری نشد.
این دومین مقاله از مجموعهای است درباره اینکه چگونه هوش مصنوعی جلسات کلاسیک تیم میانوظیفهای توسعه را تغییر میدهد. در مقاله اول به پالایش بکلاگ پرداختم و به این نتیجه اصلی رسیدم: هوش مصنوعی خودِ توافق تیم را سرعت نمیبخشد، بلکه آمادهسازی مواد برای آن را سرعت میبخشد. حالا منطقی است به گام بعدی برویم — برنامهریزی اسپرینت — و ببینیم چگونه آمادهسازی برای آن را سرعت ببخشیم بدون از دست دادن مسئولیتپذیری تیم در قبال هدف، حجم و واقعگرایی اسپرینت.
در نگاه اول به نظر میرسد که پس از یک پالایش خوب، برنامهریزی باید تقریباً به یک تشریفات فنی تبدیل شود. اقلام بکلاگ پیشتر شفاف شدهاند، معیارهای پذیرش طرح شدهاند، ریسکها نوشته شدهاند، پرسشهای باز تا حدی بسته شدهاند و گزینههای رویکرد فنی آماده شدهاند. فقط میماند انتخاب وظایف برای اسپرینت و تقسیم آنها میان افراد.
اما این دقیقاً همان تله است.
برنامهریزی اسپرینت در اسکرام یک جلسه تقسیم وظایف نیست. این رویدادی است که در آن تیم به سه پرسش مهمتر پاسخ میدهد: چرا این اسپرینت ارزشمند است، واقعاً چه چیزی میتوان در طول اسپرینت انجام داد و کار انتخابشده چگونه انجام خواهد شد. و اگر با این چارچوب به هوش مصنوعی نگاه کنیم، نکته اصلی آشکار میشود: هوش مصنوعی واقعاً میتواند به تیم کمک کند تا گزینههای برنامه را سریعتر جمعآوری کند، وابستگیها را برجسته کند، تجزیه پیشنهاد دهد و پرسشها را آماده کند. اما نمیتواند مسئولیتپذیری در قبال هدف اسپرینت را بر عهده بگیرد و نمیتواند بهخودیخود برنامه را واقعگرایانه کند.
«هوش مصنوعی کمک میکند برنامهای شبیه به واقعگرایانه ساخته شود. تنها تیم است که آن را واقعگرایانه میکند.»
به نظر من، تغییر اصلی دقیقاً همینجاست. هوش مصنوعی آمادهسازی برای برنامهریزی اسپرینت را سرعت میبخشد، اما خودِ برنامهریزی اسپرینت را بهعنوان توافق تیمی درباره هدف، حجم و شیوه تحویل جایگزین نمیکند.
چرا برنامهریزی اسپرینت فقط «چیدن وظایف در اسپرینت» نیست
در راهنمای اسکرام ۲۰۲۰، برنامهریزی اسپرینت بهعنوان رویدادی توصیف شده که اسپرینت را آغاز میکند. نتیجه آن از طریق کار مشترک کل تیم توسعه ایجاد میشود.
برنامهریزی اسپرینت حول سه موضوع ساخته میشود
- چرا این اسپرینت ارزشمند است؟
- چه چیزی میتواند در این اسپرینت انجام شود؟
- کار انتخابشده چگونه انجام خواهد شد؟
این ترتیب مهم است. ابتدا فهرست وظایف نیست، بلکه ارزش است. نه «چه چیزی را موفق میشویم ببندیم»، بلکه «چه تغییری را میخواهیم تا پایان اسپرینت به دست آوریم». به همین دلیل هدف اسپرینت یک خط تزئینی در جیرا و نه یک خلاصه کوتاه زیبا از وظایف انتخابشده نیست. این هدف واحد اسپرینت است، یعنی هدفی واحد که به تیم تمرکز میدهد و اجازه میدهد وقتی در طول اسپرینت واقعیتهای جدیدی پدیدار میشوند، تصمیم بگیرد.
بکلاگ اسپرینت در این میان از سه بخش تشکیل شده است: هدف اسپرینت بهعنوان «چرا»، اقلام انتخابشده بکلاگ بهعنوان «چه» و برنامه عملی بهعنوان «چگونه». و بهویژه مهم است که بکلاگ اسپرینت برنامهای است که توسعهدهندگان برای توسعهدهندگان ساختهاند. مالک محصول به آمادهسازی بحث و پیوند دادن کار انتخابشده با هدف محصول کمک میکند، اسکرام مستر کمک میکند رویداد مفید و سازنده باشد، اما برنامه اجرا و مسئولیتپذیری در قبال واقعگرایی بخش مهندسی درون تیم توسعه باقی میماند.
از این نتیجه یک نکته ساده اما بسیار مهم برای گفتوگو درباره هوش مصنوعی برمیآید: ابزار میتواند یک بیان برای هدف اسپرینت، فهرستی از اقلام اولیه بکلاگ، وابستگیها، ریسکها و تجزیه پیشنهاد دهد. اما نمیتواند حامل تعهد تیمی باشد. نمیتواند بهجای تیم بگوید: «ما واقعاً آمادهایم این را بر عهده بگیریم».
هوش مصنوعی واقعاً چه چیزی را در برنامهریزی تغییر میدهد
بیایید فوراً مرز شواهد را مشخص کنیم. امروزه پایه پژوهشی قوی بهطور خاص درباره برنامهریزی اسپرینت با کمک هوش مصنوعی در تیمهای واقعی اسکرام اندک است. آثار بسیار بیشتری در موضوعات مرتبط وجود دارد: مهندسی نیازمندیها، کیفیت داستانهای کاربر، برآورد трудозатрат، تولید آزمون، تصمیمگیری انسان همراه با هوش مصنوعی و مدیریت ریسک هوش مصنوعی. بنابراین درستتر است که نگوییم «هوش مصنوعی اسپرینت را برنامهریزی میکند»، بلکه بگوییم «هوش مصنوعی جمعآوری پیشنویس برنامه مورد بحث را سرعت میبخشد و به تیم کمک میکند بخشی از شکافها را زودتر ببیند». این تفاوت مهمی است.
پیش از ظهور هوش مصنوعی، آمادهسازی برای برنامهریزی اسپرینت اغلب نسبتاً دستی بود. مالک محصول از پیش اولویتها را بررسی میکرد و میکوشید حجم اولیه کار را جمعآوری کند. تحلیلگر بررسی میکرد که اقلام بکلاگ تا چه حد برای بحث آمادهاند. توسعهدهندگان محدودیتهای فنی و وظایف مشابه را به یاد میآوردند. QA ریسکهای آزمون را مطرح میکرد. اسکرام مستر مراقب بود که جلسه به بحثی آشفته درباره جزئیاتی تبدیل نشود که باید پیشتر روشن میشدند.
با هوش مصنوعی، این لایه آمادهسازی میتواند بهطور محسوسی سریعتر شود — به شرطی که تیم زمینه ورودی باکیفیت و فرایند روشنی برای بررسی نتیجه داشته باشد. مدل میتواند به جمعآوری چند گزینه برای Sprint Goal کمک کند، آیتمهای بکلاگ را حول هدف گروهبندی کند، نقاط ضعف معیارهای پذیرش را برجسته کند، فهرستی از وابستگیها پیشنهاد دهد، وظایف مشابه را در تاریخچه پیدا کند، ریسکها را طرح کند و سؤالاتی برای QA، بکاند، فرانتاند و طراحی آماده کند. اما این اثبات آن نیست که planning نهایی همیشه سریعتر یا دقیقتر میشود: بخشی از سود ممکن است صرف بررسی انسانی، راستیآزمایی منابع و اصلاح خطاهای پیشنویس شود.
این موضوع بهویژه زمانی مفید است که تیم پس از refinement با کمک هوش مصنوعی به planning میآید. در مقاله قبلی نشان دادم که هوش مصنوعی کمک میکند یک درخواست خام سریعتر به آیتم بکلاگ بالغتری تبدیل شود. اما اکنون سؤال بعدی پیش میآید: اگر آیتمهای بکلاگ بهتر به نظر برسند، آیا این یعنی برنامه هم بهتر شده است؟
لزوماً نه.
هوش مصنوعی میتواند مصنوعات planning را مرتبتر کند. میتواند این حس را ایجاد کند که همهچیز به هم متصل است: اینک Sprint Goal، اینک حجم کار، اینک ریسکها، اینک وابستگیها، اینک یادداشتهای تست. اما این هنوز برنامه نیست. این پیشنویس برنامه است. و ارزش Sprint Planning دقیقاً در این است که تیم این پیشنویس را با واقعیت بسنجد.
هوش مصنوعی کمک میکند گزینههای Sprint Goal، حجم کار، وابستگیها و ریسکها سریعتر جمعآوری شوند، اما جای بررسی واقعگرایی برنامه توسط تیم را نمیگیرد.
بیایید همان مورد را ادامه دهیم: B2B LMS و یادآوریهای ایمیلی
برای اینکه انتزاعی صحبت نکنیم، مورد مقاله اول را ادامه میدهم.
یک پلتفرم B2B LMS برای آموزش سازمانی وجود دارد. مشتریان بزرگ دورههای اجباری compliance، امنیت و مقررات داخلی را به کارمندان اختصاص میدهند. کسبوکار میخواهد یادآوریهای ایمیلی خودکار برای کارمندانی اضافه کند که دوره اجباری را تا مهلت مقرر تکمیل نکردهاند.
در refinement تیم قبلاً فهمیده است که این وظیفه فقط ساده به نظر میرسد. در واقع باید توافق شود:
- چه کسی واجد شرایط دریافت یادآوری محسوب میشود؛
- آیا فقط دورههای اجباری در نظر گرفته شوند؛
- کدام وضعیتها لحاظ شوند:
not_started،in_progress،expired؛ - چگونه
archivedو کاربران غیرفعال حذف شوند؛ - منطقه زمانی کجا ذخیره میشود؛
- تنظیم زبان و fallback زبان چگونه کار میکند؛
- چگونه هنگام اجرای مجدد وظیفه زمانبند از تکرار جلوگیری شود؛
- آیا تاریخچه / گزارش حسابرسی لازم است؛
- چه چیزی باید برای تیم پشتیبانی مشتری قابل مشاهده باشد؛
- حداقل حجم کار نسخه اول کجا تمام میشود.
پس از یک refinement خوب، تیم میتواند با پیشنویس قوی به Sprint Planning بیاید. برای مثال، هوش مصنوعی به جمعآوری پیشنویس داستان کاربر، معیارهای پذیرش، فهرست موارد مرزی، گزینههای رویکرد فنی و سؤالات باز کمک کرده است. اما در planning باید نوع دیگری از تصمیم گرفته شود: تیم دقیقاً چه چیزی را در اسپرینت پیش رو برمیدارد و با چه هدفی.
یک Sprint Goal ضعیف برای چنین موردی میتواند اینگونه باشد:
«ساخت زمانبند، یادآوریهای ایمیلی و تاریخچه.»
از نظر صوری روشن است، اما این فقط فهرستی از اجزاست. توضیح نمیدهد چرا اسپرینت ارزشمند است، چه حداقل نتیجهای باید پدید آید و چه مصالحههایی مجازند.
یک بیان قویتر:
«سیستم یک یادآوری صحیح برای کارمندان فعال با دوره اجباری ناتمام تا مهلت مقرر ارسال میکند و تاریخچه قابل بررسی ارسال را نگه میدارد.»
این بیان بهتر است، چون از قبل ارزش و مرزها را در خود دارد. ما پنل کامل مشتری را وعده نمیدهیم. منطق پیچیده یادآوری را وعده نمیدهیم. همه اختلافها درباره expiredرا یکجا حل نمیکنیم. تحلیل پیشرفته نمیسازیم. اما نتیجهای با حداقل ارزش را وعده میدهیم: کارمند موردنظر یادآوری صحیح دریافت میکند و تیم میتواند بررسی کند چه کسی، چه زمانی و چرا ایمیل ارسال شده است.
planning بدون هوش مصنوعی چگونه میبود
بدون هوش مصنوعی، چنین جلسهای اغلب با بازسازی زمینه شروع میشود. مالک محصول درخواست کسبوکار را یادآوری میکند. تحلیلگر بازگو میکند که در refinement چه چیزی روشن شده است. بکاند توضیح میدهد سرویس اعلان چگونه کار میکند. فرانتاند میپرسد آیا صفحه تنظیمات لازم است یا منطق بکاند کافی است. QA شروع به بیرون کشیدن سؤالات درباره مهلتها، مناطق زمانی، تکرارها و وضعیتها میکند. طراح تلاش میکند بفهمد آیا اصلاً UI در حجم کار اول وجود دارد.
نیمی از جلسه نه صرف انتخاب برنامه واقعگرایانه، بلکه صرف بالا آوردن دوباره مطالب در ذهن تیم میشود. در نقطهای وسوسه میشود که صرفاً «همه چیز مهم را برداریم»: واجد شرایط بودن، زمانبند، قالب ایمیل، حذف تکرار / رفع تکرار، تاریخچه، تنظیم زبان fallback، منطقه زمانی، قابلیت مشاهده اطلاعات برای تیم پشتیبانی مشتری، پردازش expired، تنظیمات مشتری و چند مورد مرزی دیگر.
چنین حجم کاری ممکن است در سطح عقل سلیم معقول به نظر برسد: همه چیز به هم مرتبط است. اما دقیقاً همینجاست که planning شروع به باد کردن میکند. تیم ظاهراً درباره یک نتیجه یکپارچه صحبت میکند، اما در واقع چند جهت مستقل عدم قطعیت را جمع میکند. جایی معناشناسی محصول مبهم است، جایی پیادهسازی فنی، جایی تست، جایی UI، جایی پشتیبانی.
در نتیجه تا پایان جلسه ممکن است Sprint Backlog ای پدید بیاید که کامل به نظر میرسد اما شکننده میماند. این بر پایه امید ساخته شده که همه نقاط بحثبرانگیز در طول اسپرینت حل خواهند شد. گاهی اینطور میشود. اما اغلب دقیقاً همینطور است که تیم انتقال کار ناتمام، خزش پنهان حجم کار و احساس ناخوشایند «ما که ظاهراً همه چیز را بحث کردیم» را تجربه میکند.
چگونه planning با AI تغییر میکند
با AI همان جلسه میتواند در سطح دیگری آغاز شود.
پیش از planning، AI به مالک محصول کمک میکند چند نسخه از Sprint Goal را آماده کند: نسخه اول باریک، حجم کار گستردهتر مشتریمحور، حجم کار ایمن از نظر فنی، حجم کار جاهطلبانه گسترده. تحلیلگر از AI میخواهد عناصر بکلاگ را با هر نسخه از هدف مرتبط کند و نشان دهد کدامیک هدف را مستقیماً پشتیبانی نمیکنند. بکاند توضیح معماری اعلانها را از AI عبور میدهد و میخواهد ریسکهای وظایف زمانبند، حذف تکراری و idempotency را برجسته کند. فرانتاند و طراح بررسی میکنند آیا UI در اسپرینت اول لازم است یا میتوان به نمایش حداقلی تاریخچه بسنده کرد. QA از AI میخواهد فهرستی از سناریوهای منفی، سناریوهای مرزی و سناریوهای وابسته به زمان آماده کند.
تیم به planning نه با صفحهای خالی، بلکه با مجموعهای از گزینهها میآید:
- حداقل حجم کار: دورههای اجباری،
not_started/in_progress، استثنای کاربران archived و غیرفعالشده، یک یادآوری، حذف تکراریها، ژورنال تاریخچه؛ - حجم کار گسترده: بهعلاوه تنظیم زبان fallback و سیاست دقیقتر منطقه زمانی؛
- حجم کار جاهطلبانه گسترده: بهعلاوه قابلیت مشاهده برای تیم پشتیبانی مشتریان؛
- خارج از حجم کار:
expired، قواعد پیچیده دورهای، تحلیلهای گسترده، زمانبندیهای فردی بر اساس مشتری.
این کار بهشدت در کار شناختی صرفهجویی میکند. اکنون تیم بخش بزرگی از جلسه را صرف نخستین صورتبندی گزینهها نمیکند. تیم بحث میکند کدام گزینه واقعبینانه است، کدام بهتر Sprint Goal را پشتیبانی میکند و کدام ریسکها را نمیتوان نامشخص رها کرد.
اما دقیقاً همینجاست که تله جدیدی ظاهر میشود. برنامهای که AI جمعآوری کرده ممکن است چنان مرتب به نظر برسد که تیم بهجای بررسی آن، شروع به ویرایشش کند. بهجای پرسیدن «آیا واقعاً میتوانیم این را انجام دهیم؟»، فقط صورتبندیها را بهتر کند. بهجای بحث درباره ظرفیت در دسترس تیم، به تجزیه زیبا اعتماد کند. بهجای بررسی وابستگیها، فرض کند اگر در جدول آمدهاند پس قبلاً لحاظ شدهاند.
و آنگاه AI به planning کمک نمیکند. فقط یک برنامه بیشازحد خوشبینانه را قانعکنندهتر میکند.
تله اصلی: واقعگرایی کاذب برنامه
در refinement بزرگترین ریسک، وضوح کاذب بود: وظیفه واضح به نظر میرسد چون AI آن را زیبا قالببندی کرده. در Sprint Planning ریسک متفاوت است — واقعگرایی کاذب.
واقعگرایی کاذب زمانی پدید میآید که برنامه منسجم، کامل و منطقی به نظر میرسد، اما در برابر محدودیتهای واقعی تیم بررسی نشده است. این برنامه Sprint Goal، فهرست وظایف، برآوردها، وابستگیها و ریسکها دارد. اما هیچکس واقعاً بررسی نکرده آیا ظرفیت در دسترس تیم کافی است، آیا کار ناتمام از اسپرینت قبل وجود دارد، آیا QA بیشازحد بارگذاری شده، آیا متخصص لازم در دسترس است، آیا واقعاً میتوان به Definition of Done رسید و آیا سختترین بخش زیر کلمات «یکپارچهسازی»، «افزودن پشتیبانی» یا «در نظر گرفتن موارد مرزی» پنهان نشده است.
این ریسک بهخوبی با چند مسئله شناختهشده جور درمیآید.
اول — خطای برنامهریزی. تیمها از قبل تمایل دارند پیچیدگی کار آینده را دستکم بگیرند، بهویژه وقتی از «درون» به برنامه نگاه میکنند و بر سناریوی مطلوب تمرکز میکنند. AI میتواند کمک کند اگر دادههای تاریخی، وظایف مشابه، تأخیرهای گذشته و دلایل معمول انتقال کار ناتمام را برجسته کند. اما میتواند خطای برنامهریزی را تشدید کند اگر روایتی صاف و قانعکننده بسازد: «همه چیز منسجم به نظر میرسد، پس همه چیز واقعبینانه است».
دوم — سوگیری اتوماسیون. وقتی سیستم برنامهای مرتب پیشنهاد میدهد، برای انسان آسانتر است از حالت بررسی فعال به حالت تأیید منفعل برود. تیم دیگر فعالانه به دنبال تناقضها نمیگردد، چون «AI همه چیز را جمع کرده». این بهویژه در planning خطرناک است، جایی که کیفیت تصمیم به کامل بودن متن بستگی ندارد، بلکه به صداقت بحث درباره محدودیتها بستگی دارد.
سوم — توهم مدل یا confabulation / ساختن مطمئن. AI میتواند با اطمینان وابستگیای را از خود بسازد که وجود ندارد. یا به «وظیفه مشابهی» ارجاع دهد که در واقع فقط سطحی مشابه بوده. یا نتیجهگیری نادرستی درباره وضعیتها، منطقه زمانی، تنظیم زبان fallback یا محدودیت معماری بگیرد. مشکل این نیست که چنین خطاهایی همیشه فاحشاند. برعکس، خطرناکترین خطاها باورپذیر به نظر میرسند.
چهارمین مورد — شبهدقت است. اگر هوش مصنوعی یک برآورد زیبا، یک بازه مرتب یا یک توالی مطمئن از گامها ارائه دهد، ممکن است در تیم احساس دقت ایجاد شود. اما دقت برنامهریزی از یک جدول خوب زاده نمیشود. پژوهشها در زمینه برآورد تلاش در Agile نشان میدهند که کیفیت برآوردها به عوامل متعددی بستگی دارد: تجربه تیم، تجربه پیشین، اندازه وظایف، کیفیت اطلاعات، رویه برآورد، مدیریت پروژه و تأثیرات کسبوکار. بنابراین خطرناک است که بنویسیم یا فکر کنیم هوش مصنوعی «برآوردها را بهبود میدهد» بهخودیخود. صورتبندی صادقانهتر این است: هوش مصنوعی میتواند به شناسایی اطلاعات جاافتاده، موارد مشابه و فرضهای ناپایدار کمک کند، اما برآورد همچنان باید توسط تیم بررسی شود.
بنابراین استفاده بالغ از هوش مصنوعی در Sprint Planning نه با این پرسش آغاز میشود که «چه برنامهای برای ما ساخت؟»، بلکه با این پرسش که «چه چیزی در این برنامه ممکن است نادرست، ناقص یا بیش از حد صاف و بیعیب باشد؟». یک تیم خوب فقط پیشنویس هوش مصنوعی را بهبود نمیدهد، بلکه آگاهانه تلاش میکند آن را رد کند: منابع، فرضها، وابستگیها، ظرفیت در دسترس تیم، Definition of Done و جاهایی را بررسی میکند که مدل ممکن است با اطمینان بیش از آنچه واقعیتها اجازه میدهند تعمیم داده باشد.
چه چیزی بر حسب نقشها تغییر میکند
مالک محصول
مالک محصول با هوش مصنوعی سریعتر گزینههای Sprint Goal و دامنه کار را به دست میآورد. او میتواند از مدل بخواهد چند سناریو نشان دهد: حداقلی، ایمن، جاهطلبانه، کششی. میتواند سریعتر ببیند کدام اقلام بکلاگ واقعاً از هدف پشتیبانی میکنند و کدامها فقط «آنها هم مفیدند».
اما مسئولیت مالک محصول از بین نمیرود. برعکس، برجستهتر میشود. اگر هوش مصنوعی پیشنهاد کند هر چیزی که مرتبط به نظر میرسد در اسپرینت گرفته شود، مالک محصول باید پرسش ارزش را نگه دارد: چه نتیجه حداقلی واقعاً برای کاربر یا ذینفع لازم است؟ چه چیزی را میتوان الان انجام نداد؟ چه چیزی Sprint Goal را نابود میکند و چه چیزی فقط خوب است که داشته باشیم؟
تحلیلگر کسبوکار
برای تحلیلگر، هوش مصنوعی بهعنوان ابزاری برای بررسی انسجام مفید است. به یافتن سریع شکافها در معیارهای پذیرش، تناقضها میان اقلام بکلاگ، فرضهای ضمنی و پرسشهایی که باید در برنامهریزی مطرح شوند کمک میکند.
اما تحلیلگر همچنان انسانی میماند که یک نیاز formally زیبا را از یک نیاز واقعاً بررسیشده تشخیص میدهد. در مورد LMS، دقیقاً تحلیلگر باید توجه کند که «دوره ناتمام» یک اصطلاح بدیهی نیست. این وضعیتهای مشخص، استثناها، مهلتها، قواعد مشتری و دادههای موجود در سیستم است.
توسعهدهنده بکاند
بکاند از هوش مصنوعی یک گذر اولیه سریع بر ریسکهای فنی میگیرد: وظایف زمانبند، idempotency، کلید حذف تکراری، گزارش حسابرسی، منطق تلاش مجدد، یکپارچهسازی با سرویس اعلان. این آمادهسازی را تسریع میکند.
اما هوش مصنوعی کل معماری واقعی را آنگونه که تیم میشناسد نمیداند. ممکن است طرحی معقول پیشنهاد دهد که محدودیتهای legacy، صف ناپایدار، ویژگیهای داده یا توافقهای میان سرویسها را در نظر نگیرد. بنابراین بکاند نباید تجزیه فنی هوش مصنوعی را «بپذیرد». باید آن را نقد کند.
توسعهدهنده فرانتاند
فرانتاند میتواند سریعتر بررسی کند که آیا UI در دامنه اولیه کار لازم است، چه حالتهایی باید نمایش داده شوند، کاربر تاریخچه ارسالها را چگونه میبیند، آیا مدیریت تنظیمات لازم است یا نمای فقطخواندنی کافی است.
اما برنامهریزی باید صادقانه پاسخ دهد: آیا UI واقعاً برای Sprint Goal لازم است یا این уже گسترش دامنه است؟ اگر هدف ارسال درست یادآوری و حفظ تاریخچه قابل بررسی است، شاید یک رابط کاربری کامل در اسپرینت اول لازم نباشد. هوش مصنوعی میتواند در صورتبندی گزینهها کمک کند، اما تیم باید سازش را بپذیرد.
مهندس کیفیت / مهندس QA
QA احتمالاً بیش از آنچه به نظر میرسد از هوش مصنوعی سود میبرد. مدل بهسرعت سناریوهای منفی، سناریوهای مرزی، سناریوهای وابسته به زمان، بررسی منطقه زمانی، fallback زبانی، کاربران archived و غیرفعالشده، اجراهای مکرر وظیفه زمانبند و حذف موارد تکراری را تولید میکند.
اما دقیقاً QA باید تیم را از پوشش کاذب محافظت کند. فهرست بلند ایدههای تست هنوز به معنای آن نیست که برنامه قابل تست است. برنامه تنها زمانی قابل تست است که معیارهای پذیرش یکتا باشند، دادهها در دسترس باشند، مشاهدهپذیری روشن باشد و تیم بداند چگونه انجام Definition of Done را اثبات کند.
طراح UX/UI
طراح با هوش مصنوعی سریعتر گزینههای رویکرد UI را جمع میکند: تنظیمات یادآوری، تاریخچه ارسالها، حالتهای خطا، راهنمایی برای تیم پشتیبانی مشتری. اما در برنامهریزی وظیفه او گسترش دامنه با قابلیتهای زیبای رابط کاربری نیست، بلکه کمک به جدا کردن ضروری از مطلوب است.
در مورد ما، یک dashboard کامل ممکن است مفید باشد اما برای اولین Sprint Goal الزامی نیست. اگر طراح به محدود کردن مسیر کاربر بدون از دست دادن ارزش کمک کند، واقعگرایی برنامه را افزایش میدهد.
اسکرام مستر
اسکرام مستر در برنامهریزی با کمک هوش مصنوعی نه «برگزارکننده جلسه» بلکه مدافع کیفیت تعهد تیمی میشود. وظیفه او این است که مراقب باشد پیشنویس هوش مصنوعی بهخودیخود مرجعیت پیدا نکند.
پرسشهای خوب اسکرام مستر در اینجا چنین به گوش میرسند:
- آیا واقعاً میفهمیم چرا این اسپرینت ارزشمند است؟
- آیا توسعهدهندگان این Sprint Backlog را برنامه خود میدانند؟
- چه چیزی را در پیشنویس هوش مصنوعی با واقعیتها بررسی کردهایم؟
- کجا برنامه بیش از حد صاف به نظر میرسد؟
- اگر اطلاعات جدیدی بیاید، اول چه چیزی را حذف میکنیم؟
- آیا Sprint Goal به فهرستی از وظایف تبدیل نشده است؟
مقایسه: Sprint Planning بدون AI و با AI
| حوزه برنامهریزی | بدون AI | چه چیزی با AI تغییر میکند |
|---|---|---|
| Sprint Goal | در یک بحث زنده و گاهی پس از انتخاب وظایف فرموله میشود | AI به سرعت چندین گزینه برای هدف پیشنهاد میدهد |
| انتخاب دامنه کار | تیم به ترتیب درباره آیتمهای بکلاگ بحث میکند و اغلب بر سر مرزها جدل میکند | AI فهرست کوتاهی، گزینههای جایگزین دامنه کار و پیشنهادهای خارج از دامنه کار را جمعآوری میکند |
| ظرفیت در دسترس تیم | به صورت دستی بر اساس افراد، مرخصیها، پشتیبانی و انتقال کار ناتمام محاسبه میشود | AI میتواند سیگنالهای تاریخی و محدودیتهای تقویمی را جمعآوری کند |
| وابستگیها | از طریق حافظه و تجربه تیم آشکار میشوند | AI وابستگیهای اولیه را سریعتر از متن و تاریخچه استخراج میکند |
| تجزیه | توسعهدهندگان خودشان کار را تجزیه میکنند | AI تجزیه را سریعتر و با جزئیات بیشتر پیشنهاد میدهد |
| تست | QA به صورت دستی سناریوهای بحرانی را مطرح میکند | AI گزینههای اولیه سناریوهای منفی و مرزی را تولید میکند |
| مدیریت ریسک | ریسکها اغلب به صورت پراکنده بیان میشوند | AI به سرعت فهرست ریسکها و ثبت فرضیات را تشکیل میدهد |
| تعهد تیمی | از توافق تیمی پس از بحث پدید میآید | AI برنامهای صیقلخورده میسازد که پذیرش آن آسانتر است |
| مستندسازی | اغلب پس از جلسه به صورت دستی تکمیل میشود | AI به سرعت تصمیمها، فرضیات و اقدامات بعدی را ثبت میکند |
ریسکهای جدید و آنچه باید دستی بررسی شود
| حوزه برنامهریزی | ریسک جدید | آنچه باید دستی بررسی شود |
|---|---|---|
| Sprint Goal | Sprint Goal به خلاصه کوتاه و زیبایی از دامنه کار تبدیل میشود | آیا در هدف «چرا» وجود دارد، نه فقط «چه کاری انجام میدهیم» |
| انتخاب دامنه کار | کامل بودن کاذب و فشردهسازی بیش از حد دامنه کار | آیا هر آیتم واقعاً برای Sprint Goal لازم است؟ اول چه چیزی را میتوان حذف کرد؟ |
| ظرفیت در دسترس تیم | نادیده گرفتن حواسپرتیهای واقعی، باگها، پشتیبانی و جلسات | آیا مرخصیها، بار پشتیبانی، کار ناتمام، جلسات اجباری و انتظار برای وابستگیهای خارجی در نظر گرفته شدهاند |
| وابستگیها | مدل ممکن است وابستگیای ناموجود بسازد یا وابستگی سازمانی را نادیده بگیرد | همه وابستگیهای خارجی توسط افراد تأیید شده و مسئول دارند |
| تجزیه | تیم به صورت منفعل منطق تجزیه دیگران را میپذیرد | تجزیه منعکسکننده معماری، ریسکها و Definition of Done تیم است |
| تست | پوشش کاذب: تستهای زیاد، اما نه حالتهای شکست | آیا معیارهای پذیرش قابل بررسی، قابلیت مشاهده و داده برای تست وجود دارد |
| مدیریت ریسک | فهرست کامل به نظر میرسد و موضوع را میبندد | کدام ریسکها با واقعیت تأیید نشدهاند؟ کدام را میتوان همین حالا کاهش داد؟ |
| تعهد تیمی | رقیق شدن مالکیت / مسئولیت: «برنامه قبلاً جمعآوری شده است» | توسعهدهندگان صراحتاً Sprint Backlog را به عنوان برنامه خود تأیید کردهاند |
| مستندسازی | در صورتجلسه نه توافقها، بلکه عبارات متقاعدکننده مدل راه مییابند | همه تصمیمهای کلیدی، واقعیتها و سؤالات باز توسط شرکتکنندگان تأیید شدهاند |
نکته اصلی در این جدول این نیست که AI «planning را بهتر انجام میدهد». اندیشه دقیقتر این است: AI تقریباً در همه جا جمعآوری پیشنویسها، فهرستها، گزینهها و صورتجلسهها را تسریع میکند. اما تقریباً هیچ جا آخرین چرخه انسانی بررسی از نظر واقعیت، واقعگرایی و مالکیت / مسئولیت را حذف نمیکند.
حاکمیت و بهداشت داده: آنچه نباید بیفکر به مدل سپرد
در planning اغلب وسوسه میشود که همه چیز به AI داده شود: وظایف در Jira، رشتههای بحث در Slack، درخواستهای مشتری، گزارشهای پشتیبانی، بخشهایی از مستندات، تقویم تیم، تاریخچه حوادث، مکاتبات با ذینفعان. از نظر کیفیت planning این قابل درک است: هرچه زمینه بیشتر باشد، پیشنویس بهتر است.
اما از نظر governance این خطرناک است.
اگر تیم از AI برای آمادهسازی Sprint Planning استفاده میکند، باید از قبل توافق کند که چه دادههایی را میتوان به مدل داد و چه دادههایی را نمیتوان، چه کسی نتیجه را بررسی میکند و چگونه نقاط بحثبرانگیز ثبت میشوند. در اینجا یک رویکرد ساده governance خوب کار میکند: صراحتاً بررسیهای مسئولانه تعیین شوند، واقعیتها از فرضیات جدا شوند، موارد ناشناخته ثبت شوند، بازنویسیهای دستی مهم تیم بر توصیههای AI حفظ شوند و منابع برای ادعاهای کلیدی بررسی شوند. در پرامپتها / درخواستهای به مدل نباید بیفکر وارد کرد:
- نامهای واقعی مشتریان؛
- آدرسهای ایمیل کاربران و کارمندان؛
- دادههای تولیدی؛
- جزئیات حوادث امنیتی؛
- اعتبارنامهها، توکنها، کلیدهای API؛
- گزارشهای کامل حسابرسی؛
- اسناد حقوقی و شرایط قراردادها؛
- اطلاعات HR؛
- جزئیات حساس تجاری که برای planning لازم نیستند.
کار با زمینه کمینهشده و بینامشده ایمنتر است: جایگزینی شناسههای واقعی با جایگزینهای بینام، استفاده از ویرایش با حذف دادههای حساس / ناشناسسازی، ارسال الگوهای تاریخی تجمیعشده به جای خروجیهای خام، جدا کردن واقعیتها از فرضیات و ثبت اینکه کدام پرامپتها / درخواستهای به مدل و پاسخهای مدل واقعاً در آمادهسازی planning استفاده شدهاند.
این بوروکراسی نیست. این راهی است برای اینکه AI-assisted planning به کانال نشت داده تبدیل نشود و به مدل زمینه بیشتری از آنچه برای یک تصمیم مشخص لازم است داده نشود.
چکلیست: Sprint Plan جمعآوریشده با AI را میتوان بحث کرد، اگر…
این چکلیست یک آرتیفکت رسمی اسکرام نیست. این یک فیلتر عملی است که به تیم کمک میکند پیشنویس AI را با برنامه واقعی اشتباه نگیرد.
Sprint Plan جمعآوریشده توسط AI را میتوان بحث کرد، اگر:
- Sprint Goal بهصورت یک ارزش یا وضعیت تغییریافته برای کاربر / ذینفع بیان شده باشد، نه بهصورت فهرستی از وظایف.
- برای هر آیتم انتخابشده از بکلاگ، تیم بتواند توضیح دهد که آن چگونه از Sprint Goal پشتیبانی میکند.
- ظرفیت در دسترس تیم نه بهصورت انتزاعی، بلکه با در نظر گرفتن مرخصیها، پشتیبانی، رفع باگ، انتقال کار ناتمام، آنبوردینگ و جلسات اجباری لحاظ شده باشد.
- کار ناتمام از اسپرینت گذشته بهصراحت بررسی شده باشد: چه چیزی منتقل میشود، چه چیزی لغو میشود، چه چیزی نیاز به بازتخمین دارد.
- وابستگیهای خارجی بهصراحت نامبرده شده باشند، هر کدام مسئول و وضعیت روشن داشته باشند.
- برای حجم کار انتخابشده، تیم مسیر رسیدن به Definition of Done را ببیند، نه فقط وضعیت «کد تقریباً آماده است».
- برنامه قابل تست باشد: معیارهای پذیرش، سناریوهای منفی، سناریوهای مرزی، قابلیت مشاهده و دادههای روشن برای بررسی وجود داشته باشد.
- تیم بتواند با یک جمله حداقل حجم کار ارزشمند اسپرینت را نام ببرد.
- تیم از پیش بداند که اگر اطلاعات جدیدی ظاهر شود، چه چیزی اول از حجم کار حذف میشود.
- ادعاهای واقعی مهم از پیشنویس AI بهصورت دستی بررسی شده باشند: وضعیتها، وابستگیها، دادههای تاریخی، محدودیتهای معماری، قواعد مهلت، بومیسازی، حذف تکراری.
- کسی از اعضا بهطور خاص تلاش کرده باشد پیشنویس AI را رد کند، نه فقط بهبود دهد.
- تیم جداگانه بررسی کرده باشد کجا برنامه بیش از حد صاف، بیش از حد دقیق یا بهطور مشکوکی «بدیهی» است.
- توسعهدهندگان بهصراحت تأیید کرده باشند که Sprint Backlog برنامه آنهاست و Sprint Goal تعهد تیم برای اسپرینت است.
- نتیجه planning بهگونهای ثبت شده باشد که روشن باشد: چه چیزی تصمیم گرفته شد، چه چیزی فرض شد، چه چیزی ناشناخته ماند و چه چیزی خارج از حجم کار قرار گرفت.
در عمل این چکلیست را میتوان نه بهعنوان یک سد کنترلی رسمی، بلکه بهعنوان یک نظم فکری کوتاه در پایان planning استفاده کرد. دو پرسش بهویژه مفیدند: «چه چیزی در این پیشنویس AI ممکن است نادرست باشد؟» و «اگر واقعیت پیچیدهتر از آنچه هست باشد، اول چه چیزی را حذف میکنیم؟».
چیزی که به تیم توصیه میکنم
اول، استفاده از AI پیش از Sprint Planning نه برای اینکه «او اسپرینت را برنامهریزی کند»، بلکه برای اینکه او مواد لازم برای یک بحث انسانی خوب را آماده کند. بگذارید او گزینهها، وابستگیها، فرضها، ریسکها، موارد مرزی، گزینههای جایگزین حجم کار و پرسشها را جمعآوری کند. اما تصمیم باید نزد تیم بماند.
دوم، همیشه پیشنویس برنامه را از تعهد تیمی جدا کنید. پیشنویس AI میتواند یک پیشنویس عالی باشد، اما Sprint Backlog تنها زمانی واقعی میشود که توسعهدهندگان آن را برنامه خود بدانند.
سوم، تخمینهای تولیدشده توسط AI را به این دلیل که ساختاریافته به نظر میرسند، عینیتر نپذیرید. تکرارها و مرورها درباره ارزیابی خودکار / ارزیابی حجم کار با پشتیبانی AI دلایل کافی برای احتیاط فراهم میکنند: یک مدل پیچیده تنها به دلیل پیچیدگیاش بهتر از یک مدل پایه ساده نمیشود. در تخمینها نه تنها خطا، بلکه اطمینان بیش از حد نیز خطرناک است. بهتر است از AI برای شناسایی عدمقطعیتها استفاده کرد تا برای ایجاد توهم دقت.
چهارم، بهصراحت خارج از حجم کار را ثبت کنید. در جلسات خوب planning با پشتیبانی AI، ارزش اغلب نه تنها با آنچه تیم انتخاب کرده، بلکه با آنچه آگاهانه برنداشته است ایجاد میشود. در مورد LMS این میتواند expired، داشبورد کامل تیم پشتیبانی مشتریان، بخشبندی پیچیده دورهای بودن یادآوریها و تحلیلهای پیشرفته باشد.
پنجم، برای بررسی، مسئول تعیین کنید. معنای کسبوکار را مالک محصول بررسی میکند، انسجام نیازمندیها را تحلیلگر، امکانپذیری معماری را توسعهدهندگان، قابلیت تست را QA، مرزهای تجربه کاربری را طراح، کیفیت توافق تیمی را اسکراممستر. AI میتواند پیشنویس کلی را آماده کند، اما نمیتواند مالک بررسی باشد.
نتیجهگیری
اگر در Backlog Refinement، AI به جمعآوری و شکلدهی سریعتر مواد برای بحث کمک میکند، در Sprint Planning به جمعآوری سریعتر گزینههای برنامه کمک میکند. او میتواند Sprint Goal را پیشنهاد دهد، آیتمهای بکلاگ را گروهبندی کند، وابستگیها را برجسته کند، تجزیه را طرح کند، سناریوهای تست را آماده کند، فرضها را بنویسد و حتی نتیجه جلسه را بهزیبایی ثبت کند.
اما این برنامه را واقعگرایانه نمیکند.
یک Sprint Plan واقعگرایانه تنها زمانی پدید میآید که تیم صادقانه ارزش، حجم کار، ظرفیت در دسترس تیم، وابستگیها، Definition of Done، قابلیت تست و آمادگی خود برای برداشتن این کار را بررسی کرده باشد. AI میتواند این بررسی را تسریع کند، اما نمیتواند جایگزین آن شود. او میتواند به دیدن گزینههای بیشتر کمک کند، اما نمیتواند تعهد تیمی را بهجای افراد انتخاب کند.
بنابراین اثر اصلی AI در Sprint Planning را اینگونه بیان میکنم: او هزینه آمادهسازی گزینههای برنامه را کاهش میدهد، اما قیمت بررسی انسانی را افزایش میدهد. هرچه ایجاد یک برنامه زیبا آسانتر شده، درک این نکته مهمتر شده که آیا آن یک برنامه واقعی تیمی است یا نه.
در یک تیم بالغ، هوش مصنوعی برنامهریزی اسپرینت را به تولید خودکار بکلاگ اسپرینت تبدیل نمیکند. بلکه آن را به گفتوگویی دقیقتر درباره هدف، محدودیتها و مصالحهها تبدیل میکند. و این شاید مفیدترین شکل خودکارسازی باشد: نه حذف افراد از برنامهریزی، بلکه آزاد کردن توجه آنها برای تصمیمهایی که ابزار نمیتواند به جای آنها بگیرد.
منابع و نقاط مرجع
- راهنمای اسکرام ۲۰۲۰ — برنامهریزی اسپرینت، هدف اسپرینت، بکلاگ اسپرینت، حوزههای مسئولیت.
- چارچوب NIST برای مدیریت ریسک هوش مصنوعی ۱.۰ — مدیریت / قاعدهگذاری، پاسخگویی / مسئولیت، پیکربندی تعامل انسان و هوش مصنوعی.
- پروفایل NIST برای هوش مصنوعی مولد — توهمزایی / جعل مطمئن، وابستگی بیش از حد، حریم خصوصی و مدیریت ریسک.
- ChatGPT بهعنوان ابزاری برای ارزیابی کیفیت داستان کاربر — نمونهای از پایگاه شواهد متوسط برای وظایف مربوط به کیفیت داستانهای کاربر.
- مدلهای زبانی بزرگ برای مهندسی نرمافزار: مرور و مسائل باز — مروری بر LLM در توسعه نرمافزار / مهندسی نرمافزار.
- برآورد تلاش در توسعه نرمافزار چابک: مرور نظاممند ادبیات — عوامل کیفیت برآورد چابک.
- دلایل و رویکردها برای برآورد دقیق تلاش در توسعه تکراری چابک — کیفیت اطلاعات، تیم، عمل برآورد، مدیریت پروژه، تأثیر تجاری.
- گزارش تکرار GPT2SP — محدودیتهای برآورد هوش مصنوعی در امتیاز داستان و مقایسه با مدلهای پایه ساده / نقاط مرجع.
- به سوی برنامهریزی تکراری چابک قابل اعتماد از طریق پیشبینی تغییرات مستندات اقلام کاری — ارتباط تغییرات مستندات و شکنندگی برنامهریزی.
- خطای برنامهریزی — اثر کلاسیک درباره دستکمگرفتن زمانبندی.
- سوگیری خودکارسازی در سیستمهای پشتیبانی تصمیم هوشمند حساس به زمان — سوگیری خودکارسازی، خطاهای حذف و خطاهای اقدام.
- سوگیری تعمیم در خلاصهسازی مدلهای زبانی بزرگ — خطر تعمیمهای بیش از حد در خلاصههای ایجادشده توسط مدلهای زبانی بزرگ.
- OWASP Top 10 برای برنامههای LLM — اطلاعات حساس، وابستگی بیش از حد، ریسکهای پرامپت و امنیت.