
AI-assisterad Sprint Planning: hur man snabbar upp förberedelserna utan att förlora ansvar
En praktisk genomgång av hur AI förändrar Sprint Planning: var det snabbar upp förberedelserna, varför det inte tar bort teamets ansvar och hur man inte förväxlar en vacker plan med en realistisk.
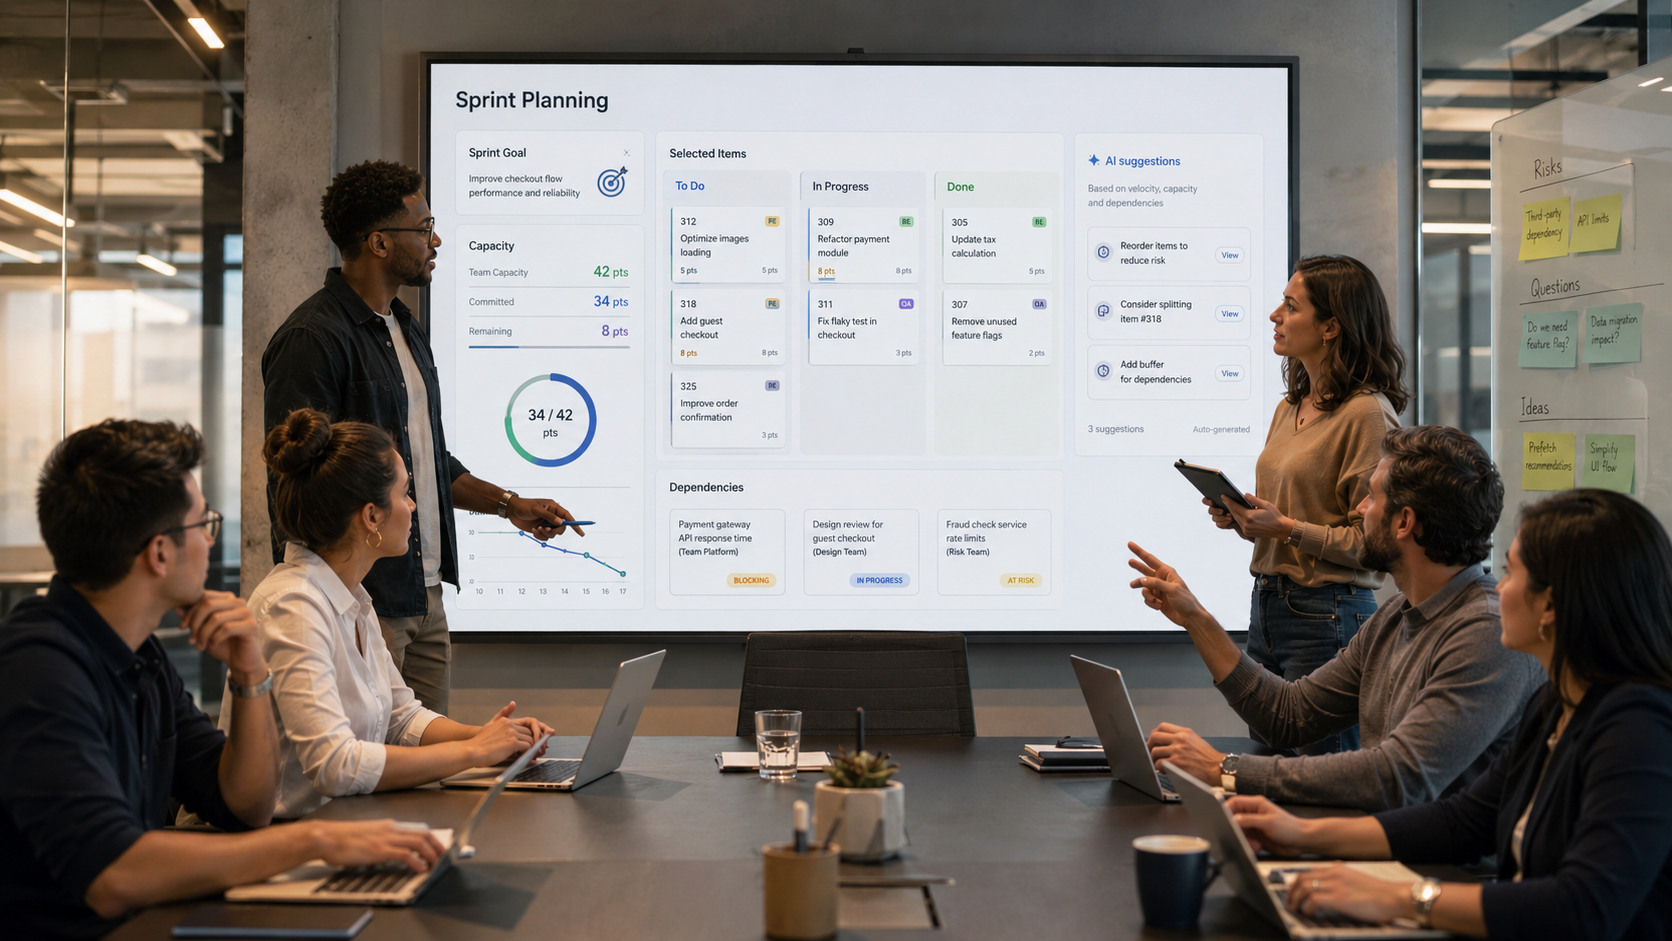 Bilden kunde inte laddas.
Det här är den andra artikeln i serien om hur AI förändrar de klassiska mötena i ett tvärfunktionellt utvecklingsteam. I den första artikeln gick jag igenom Backlog Refinement och kom fram till den viktigaste slutsatsen: AI snabbar inte upp själva teamets överenskommelse, utan förberedelsen av materialet inför den. Nu är det logiskt att gå vidare till nästa steg — Sprint Planning — och titta på hur man kan snabba upp förberedelserna inför det utan att teamet förlorar ansvaret för sprintens mål, omfattning och realism.
Vid första anblicken verkar det som att planning efter en bra refinement borde bli nästan en teknisk formalitet. Backlog-elementen är redan förfinade, acceptanskriterierna skissade, riskerna nedskrivna, de öppna frågorna delvis stängda, varianterna av teknisk ansats förberedda. Det återstår bara att välja uppgifter till sprinten och fördela dem på personer.
Men det är precis fällan.
Sprint Planning i Scrum är inte ett möte för att fördela uppgifter. Det är en händelse där teamet svarar på tre viktigare frågor: varför den här sprinten är värdefull, vad som verkligen kan göras under sprinten och hur det valda arbetet ska utföras. Och om man ser på AI genom den här ramen blir det viktigaste tydligt: AI kan verkligen hjälpa teamet att snabbare ta fram varianter av en plan, lyfta fram beroenden, föreslå nedbrytning och förbereda frågor. Men det kan inte ta på sig ansvaret för Sprint Goal och kan inte göra planen realistisk i sig självt.
”AI hjälper till att ta fram en plan som liknar en realistisk. Realistisk görs den bara av teamet.”
Det är enligt min mening precis här den viktigaste förskjutningen ligger. AI snabbar upp förberedelserna inför Sprint Planning, men ersätter inte själva Sprint Planning som teamets överenskommelse om mål, omfattning och leveranssätt.
Varför Sprint Planning inte bara är att ”fylla sprinten med uppgifter”
I Scrum Guide 2020 beskrivs Sprint Planning som en händelse som initierar sprinten. Dess resultat skapas genom hela Utvecklingsteamets gemensamma arbete.
Sprint Planning bygger på tre teman
- Varför är den här sprinten värdefull?
- Vad kan göras under den här sprinten?
- Hur ska det valda arbetet utföras?
Det är en viktig ordning. Först inte en uppgiftslista, utan värde. Inte ”vad vi hinner stänga”, utan ”vilken förändring vi vill uppnå i slutet av sprinten”. Det är just därför Sprint Goal inte är en dekorativ rad i Jira och inte en vacker kort sammanfattning av de valda uppgifterna. Det är ett gemensamt mål för sprinten, det vill säga ett gemensamt mål som ger teamet fokus och gör det möjligt att fatta beslut när nya fakta dyker upp under sprinten.
Sprint Backlog består samtidigt av tre delar: Sprint Goal som ”varför”, de valda backlog-elementen som ”vad” och en actionable plan som ”hur”. Och det är särskilt viktigt att Sprint Backlog är en plan skapad av utvecklarna och för utvecklarna. Produktägaren hjälper till att förbereda diskussionen och koppla det valda arbetet till Product Goal, Scrum Master hjälper händelsen att vara användbar och produktiv, men genomförandeplanen och ansvaret för den ingenjörsmässiga delens realism stannar inom utvecklingsteamet.
Av detta följer en enkel men mycket viktig slutsats för samtalet om AI: verktyget kan föreslå en formulering av Sprint Goal, en lista med preliminära backlog-element, beroenden, risker och nedbrytning. Men det kan inte vara bärare av teamets åtagande. Det kan inte säga å teamets vägnar: ”vi är verkligen redo att ta det här”.
Vad AI faktiskt förändrar i planning
Låt mig direkt markera gränsen för evidensen. I dag finns det lite stark forskningsbas just kring AI-assisterad Sprint Planning i verkliga Scrum-team. Det finns betydligt fler arbeten inom angränsande områden: requirements engineering, kvalitet på användarberättelser, arbetsuppskattning, testgenerering, mänskligt beslutsfattande tillsammans med AI och hantering av AI-risker. Därför är det mer korrekt att inte säga ”AI planerar sprinten”, utan ”AI snabbar upp framtagningen av ett diskuterbart utkast till plan och hjälper teamet att tidigare se en del luckor”. Det är en viktig skillnad.
Innan AI fanns var förberedelserna inför Sprint Planning ofta ganska manuella. Produktägaren tittade i förväg på prioriteringar och försökte samla en preliminär arbetsomfattning. Analytikern kontrollerade hur redo backlog-elementen var för diskussion. Utvecklarna kom ihåg tekniska begränsningar och liknande uppgifter. QA lyfte testrisker. Scrum Master höll koll på att mötet inte förvandlades till en kaotisk diskussion om detaljer som borde ha klarats ut tidigare.
Med AI kan detta förberedande lager bli märkbart snabbare – förutsatt att teamet har en kvalitativ ingångskontext och en tydlig process för att verifiera resultatet. Modellen kan hjälpa till att ta fram flera varianter av Sprint Goal, gruppera backlogobjekt kring målet, lyfta fram svaga punkter i acceptanskriterierna, föreslå en lista över beroenden, hitta liknande uppgifter i historiken, skissa risker och förbereda frågor för QA, backend, frontend och design. Men det är inte ett bevis på att den slutliga planningen alltid blir snabbare eller mer exakt: en del av vinsten kan gå åt till mänsklig granskning, verifiering av källor och rättning av fel i utkastet.
Detta är särskilt användbart när teamet kommer till planning efter AI-assisted refinement. I den föregående artikeln visade jag att AI hjälper till att snabbare omvandla en rå förfrågan till ett mer moget backlogobjekt. Men nu uppstår nästa fråga: om backlogobjekten ser bättre ut, betyder det att planen också har blivit bättre?
Inte nödvändigtvis.
AI kan göra planeringsartefakterna mer prydliga. Det kan skapa en känsla av att allt redan hänger ihop: här är Sprint Goal, här är omfattningen av arbetet, här är riskerna, här är beroendena, här är anteckningarna om testning. Men det är ännu inte en plan. Det är ett utkast till en plan. Och värdet med Sprint Planning ligger just i att teamet prövar detta utkast mot verkligheten.
AI hjälper till att snabbare ta fram varianter av Sprint Goal, omfattning av arbetet, beroenden och risker, men ersätter inte teamets granskning av planens realism.
Vi fortsätter samma fall: B2B LMS och e-postpåminnelser
För att inte tala i abstrakta termer fortsätter jag fallet från den första artikeln.
Det finns en B2B LMS-plattform för företagsutbildning. Stora kunder tilldelar anställda obligatoriska kurser inom compliance, säkerhet och interna regelverk. Verksamheten vill lägga till automatiska e-postpåminnelser till anställda som inte har slutfört en obligatorisk kurs före deadline.
Under refinement har teamet redan kommit fram till att uppgiften bara verkar enkel. I själva verket behöver man komma överens om:
- vem som ska anses uppfylla villkoren för påminnelse;
- om man bara ska ta obligatoriska kurser;
- vilka statusar som ska beaktas:
not_started,in_progress,expired; - hur man utesluter
archivedoch inaktiverade användare; - var tidszonen lagras;
- hur språkinställningen och språk-fallback fungerar;
- hur man skyddar sig mot dubbletter när schemaläggaruppgiften körs igen;
- om en historiklogg / granskningslogg behövs;
- vad kundsupportteamet ska kunna se;
- var gränsen går för den minimala omfattningen av den första versionen.
Efter en bra refinement kan teamet komma till Sprint Planning med ett redan starkt underlag. Till exempel har AI hjälpt till att ta fram ett utkast till användarberättelse, acceptanskriterier, en lista över gränsfall, varianter av tekniskt angreppssätt och öppna frågor. Men på planningen behöver man fatta en annan typ av beslut: vad exakt teamet tar in i nästa sprint och med vilket mål.
Ett dåligt Sprint Goal för ett sådant fall skulle kunna se ut så här:
”Göra scheduler, e-postpåminnelser och historiklogg.”
Formellt sett begripligt, men det är bara en lista över komponenter. Det förklarar inte varför sprinten är värdefull, vilket minimalt resultat som ska uppnås och vilka kompromisser som är acceptabla.
En starkare formulering:
”Systemet skickar en korrekt påminnelse till aktiva anställda med en ej slutförd obligatorisk kurs före deadline och sparar en verifierbar historik över utskicken.”
Denna formulering är bättre eftersom den redan innehåller värde och gränser. Vi lovar inte en fullständig kundpanel. Vi lovar inte komplex påminnelselogik. Vi löser inte alla tvister kring expiredpå en gång. Vi bygger inte avancerad analys. Men vi lovar ett minimalt värdefullt resultat: rätt anställd får en korrekt påminnelse, och teamet kan verifiera till vem, när och varför mejlet skickades.
Hur planningen skulle se ut utan AI
Utan AI börjar ett sådant möte ofta med att återställa kontexten. Produktägaren påminner om affärsförfrågan. Analytikern återberättar vad man lyckades ta reda på under refinement. Backend förtydligar hur notifikationstjänsten fungerar. Frontend frågar om en inställningsskärm behövs eller om backend-logik räcker. QA börjar dra fram frågor om deadlines, tidszoner, dubbletter och statusar. Designern försöker förstå om det överhuvudtaget finns någon UI i den första omfattningen av arbetet.
Halva mötet går åt till att lyfta materialet i teamets huvuden igen i stället för att välja en realistisk plan. Vid någon punkt uppstår frestelsen att helt enkelt ”ta allt viktigt”: uppfyllande av villkor, scheduler, mejlmall, deduplicering / eliminering av dubbletter, historiklogg, språkinställning fallback, tidszon, synlighet av information för kundsupportteamet, hantering av expired, kundinställningar och ytterligare ett par gränsfall.
En sådan arbetsvolym kan verka rimlig på sunt förnuft-nivå: allt hänger ju ihop. Men det är just här planning börjar svälla. Teamet säger sig visserligen tala om ett helhetsresultat, men samlar i själva verket flera oberoende osäkerhetsområden. Någonstans är produktsemantiken oklar, någonstans den tekniska implementeringen, någonstans testningen, någonstans UI, någonstans supporten.
Som ett resultat kan det i slutet av mötet uppstå en Sprint Backlog som ser fullständig ut men förblir bräcklig. Den bygger på förhoppningen att alla tvistefrågor löses under sprinten. Ibland blir det så. Men ofta är det precis så teamet får överförd oavslutad arbete, dold volymglidning och en obehaglig känsla: "vi har ju ändå diskuterat allt".
Hur planning förändras med AI
Med AI kan samma möte börja på en annan nivå.
Före planning hjälper AI Produktägaren att förbereda flera varianter av Sprint Goal: en snäv första version, en bredare kundarbetsvolym, en tekniskt säker arbetsvolym, en utökad ambitiös volym. Analytikern ber AI koppla backlog-elementen till varje målvariant och visa vilka av dem som inte stöder målet direkt. Backend kör genom AI beskrivningen av notifikationsarkitekturen och ber den lyfta fram riskerna med schemaläggar-, deduplicerings- och idempotensuppgifterna. Frontend och designern kontrollerar om UI behövs i den första sprinten eller om det räcker med minimal historikvisning. QA ber AI ta fram en lista med negativa scenarier, gränsscenarier och tidberoende scenarier.
Teamet kommer till planning inte med ett tomt blad utan med en uppsättning varianter:
- minimal arbetsvolym: obligatoriska kurser,
not_started/in_progress, uteslutning av archived och deaktiverade användare, en påminnelse, eliminering av dubbletter, historiklogg; - utökad arbetsvolym: plus språkinställning fallback och en mer noggrann tidszonpolicy;
- utökad ambitiös volym: plus synlighet för kundsupportteamet;
- utanför arbetsvolymen:
expired, komplexa periodicitetsregler, utökad analys, individuella scheman per kund.
Detta sparar avsevärt kognitivt arbete. Nu lägger teamet inte större delen av mötet på att för första gången formulera varianterna. Det diskuterar vilken variant som är realistisk, vilken som bäst stöder Sprint Goal och vilka risker som inte får lämnas implicita.
Men det är just här en ny fälla uppstår. En AI-sammansatt plan kan se så prydlig ut att teamet börjar redigera den istället för att granska den. Inte fråga "kan vi verkligen detta?" utan bara förbättra formuleringarna. Inte diskutera teamets tillgängliga kapacitet utan lita på den vackra nedbrytningen. Inte kontrollera beroenden utan anta att om de finns i tabellen så är de redan beaktade.
Och då hjälper AI inte planning. Den gör bara en överoptimistisk plan mer övertygande.
Huvudfällan: planens falska realism
I refinement var huvudrisken falsk klarhet: uppgiften verkar begriplig eftersom AI formaterat den vackert. I Sprint Planning är risken en annan — falsk realism.
Falsk realism uppstår när planen ser sammanhängande, fullständig och logisk ut men inte har prövats mot teamets verkliga begränsningar. Den har ett Sprint Goal, en uppgiftslista, uppskattningar, beroenden och risker. Men ingen har på riktigt kontrollerat om teamets tillgängliga kapacitet räcker, om det finns oavslutat arbete från föregående sprint, om QA är överbelastat, om rätt expert är tillgänglig, om det verkligen går att nå Definition of Done och om den svåraste delen inte är dold bakom orden "integrera", "lägga till stöd" eller "hantera gränsfall".
Denna risk passar väl in på flera kända problem.
Det första är planeringsfelet. Team tenderar redan att underskatta komplexiteten i framtida arbete, särskilt när de ser planen "inifrån" och fokuserar på det önskade scenariot. AI kan hjälpa om den lyfter historiska data, liknande uppgifter, tidigare förseningar och typiska orsaker till överfört oavslutat arbete. Men den kan också förstärka planeringsfelet om den skapar en slät övertygande historia: "allt ser sammanhängande ut, alltså är allt realistiskt".
Det andra är automatiseringsbias. När systemet föreslår en prydlig plan är det lättare för människan att gå från aktiv granskning till passivt godkännande. Teamet söker inte längre aktivt motsägelser eftersom "AI har ju satt ihop allt". Det är särskilt farligt vid planning, där beslutets kvalitet inte beror på textens fullständighet utan på ärligheten i diskussionen om begränsningar.
Det tredje är modellhallucination eller konfabulation / säkert påhittande. AI kan säkert hitta på ett beroende som inte finns. Eller hänvisa till en "liknande uppgift" som i själva verket bara var ytligt lik. Eller dra en felaktig slutsats om statusar, tidszon, språkinställning fallback eller en arkitekturbegränsning. Problemet är inte att sådana fel alltid är grova. Tvärtom ser de farligaste felen trovärdiga ut.
Den fjärde är pseudoprecision. Om AI ger en vacker uppskattning, ett prydligt intervall eller en självsäker sekvens av steg kan teamet få en känsla av precision. Men precision i planering föds inte ur en bra tabell. Forskning om Agile-arbetsuppskattning visar att kvaliteten på uppskattningar beror på många faktorer: teamets erfarenhet, tidigare erfarenhet, uppgifternas storlek, informationens kvalitet, uppskattningspraxis, projektledning och affärspåverkan. Därför är det farligt att skriva eller tro att AI "förbättrar uppskattningar" i sig själv. En mer ärlig formulering: AI kan hjälpa till att identifiera saknad information, liknande fall och instabila antaganden, men uppskattningen måste ändå granskas av teamet.
Därför börjar ett moget användande av AI i Sprint Planning inte med frågan "vilken plan har den byggt åt oss?", utan med frågan "vad i den här planen kan vara osant, ofullständigt eller alltför slätt?". Ett bra team förbättrar inte bara AI-utkastet, utan försöker medvetet motbevisa det: granskar källor, antaganden, beroenden, teamets tillgängliga kapacitet, Definition of Done och ställen där modellen kan ha generaliserat självsäkert mer än fakta tillåter.
Vad förändras per roll
Produktägare
Produktägaren får med AI snabbare varianter av Sprint Goal och omfattning av arbetet. Hen kan be modellen visa flera scenarier: minimalt, säkert, ambitiöst, stretch. Hen kan snabbare se vilka delar av backloggen som verkligen stöder målet och vilka som bara "också är användbara".
Men produktägarens ansvar försvinner inte. Tvärtom blir det tydligare. Om AI föreslår att ta in allt i sprinten som ser relaterat ut måste produktägaren hålla kvar värdeproblemet: vilket minimalt resultat behöver användaren eller intressenten verkligen? Vad kan vi låta bli nu? Vad förstör Sprint Goal och vad är bara trevligt att ha?
Affärsanalytiker
För analytikern är AI användbart som ett verktyg för att kontrollera sammanhang. Det hjälper snabbt att hitta luckor i acceptanskriterier, motsägelser mellan delar av backloggen, implicita antaganden och frågor som bör tas upp på planeringen.
Men analytikern förblir den person som skiljer ett formellt vackert krav från ett faktiskt verifierat. I LMS-fallet är det just analytikern som måste uppmärksamma att "ofullständig kurs" inte är en självklar term. Det är specifika statusar, undantag, deadlines, kundregler och data i systemet.
Backend-utvecklare
Backend får från AI en snabb första genomgång av tekniska risker: schemaläggaruppgifter, idempotens, dedupliceringsnyckel, granskningslogg, logik för återförsök, integration med aviseringstjänsten. Det påskyndar förberedelsen.
Men AI känner inte hela den verkliga arkitekturen så som teamet gör. Den kan föreslå en rimlig lösning som inte tar hänsyn till legacy-begränsningar, en instabil kö, datasärdrag eller överenskommelser mellan tjänster. Därför bör backend inte "acceptera" AI:s tekniska nedbrytning. Den bör kritisera den.
Frontend-utvecklare
Frontend kan snabbare kontrollera om UI behövs i den första omfattningen av arbetet, vilka tillstånd som måste visas, hur användaren ser historiken över utskick, om hantering av inställningar behövs eller om läsbarhet räcker.
Men planeringen måste ärligt svara: behövs UI verkligen för Sprint Goal eller är det redan en utökning? Om målet är att korrekt skicka en påminnelse och bevara en verifierbar historik är kanske ett fullständigt klientgränssnitt inte nödvändigt i den första sprinten. AI kan hjälpa till att formulera alternativ, men teamet måste acceptera kompromissen.
Kvalitetsingenjör / QA-ingenjör
QA har kanske större nytta av AI än vad som verkar. Modellen genererar snabbt negativa scenarier, gränsfallsscenarier, tidberoende scenarier, kontroller av tidszon, språklig fallback, arkiverade och inaktiverade användare, upprepade körningar av schemaläggaruppgiften och eliminering av dubbletter.
Men det är just QA som måste skydda teamet från pseudotäckning. En lång lista med testidéer betyder ännu inte att planen är testbar. Planen är testbar först när acceptanskriterierna är entydiga, data är tillgängliga, observerbarheten är tydlig och teamet förstår hur det ska bevisa att Definition of Done är uppfylld.
UX/UI-designer
Designern samlar med AI snabbare varianter av UI-ansats: påminnelseinställningar, historik över utskick, feltillstånd, tips för teamet som stöder kunder. Men på planeringen är hens uppgift inte att utöka arbetets omfattning med vackra gränssnittsfunktioner, utan att hjälpa till att skilja det nödvändiga från det önskvärda.
I vårt fall kan en fullständig dashboard vara användbar, men inte obligatorisk för det första Sprint Goal. Om designern hjälper till att snäva in användarresan utan att förlora värde ökar hen planens realism.
Scrum Master
Scrum Mastern blir i AI-assisterad planering inte "mötets organisatör", utan en försvarare av kvaliteten i teamets åtagande. Hens uppgift är att se till att AI-utkastet inte blir en auktoritet i sig självt.
Bra frågor från Scrum Mastern här låter så här:
- Förstår vi verkligen varför den här sprinten är värdefull?
- Betraktar utvecklarna den här Sprint Backloggen som sin egen plan?
- Vad i AI-utkastet har vi kontrollerat med fakta?
- Var ser planen för slät ut?
- Vad tar vi bort först om ny information dyker upp?
- Har Sprint Goal förvandlats till en uppgiftslista?
Jämförelse: Sprint Planning utan AI och med AI
| Planeringsområde | Utan AI | Vad förändras med AI |
|---|---|---|
| Sprint Goal | Formuleras i en levande diskussion, ibland redan efter att uppgifterna valts | AI föreslår snabbt flera varianter av målet |
| Val av omfattning | Teamet diskuterar backlogobjekt i tur och ordning och bråkar ofta om gränserna | AI sammanställer en kort lista, alternativa omfattningsvarianter och förslag utanför omfattningen |
| Teamets tillgängliga kapacitet | Beräknas manuellt utifrån personer, semestrar, support och överföring av oavslutat arbete | AI kan sammanställa historiska signaler och kalenderbegränsningar |
| Beroenden | Dyker upp genom teamets minne och erfarenhet | AI tar snabbare fram preliminära beroenden från text och historik |
| Nedbrytning | Utvecklarna delar upp arbetet själva | AI föreslår nedbrytning snabbare och mer detaljerat |
| Testning | QA tar manuellt upp kritiska scenarier | AI genererar preliminära varianter av negativa och gränsfallsscenarier |
| Riskhantering | Risker nämns ofta fragmentariskt | AI formar snabbt en risklista och ett register över antaganden |
| Teamets åtagande | Uppstår genom teamets samtycke efter diskussion | AI skapar en polerad plan som är lättare att acceptera |
| Dokumentation | Skrivs ofta till manuellt efter mötet | AI dokumenterar snabbt beslut, antaganden och uppföljningsåtgärder |
Nya risker och vad som ska kontrolleras manuellt
| Planeringsområde | Ny risk | Vad som ska kontrolleras manuellt |
|---|---|---|
| Sprint Goal | Sprint Goal förvandlas till en vacker kort sammanfattning av omfattningen | Finns det ett “varför” i målet, inte bara “vad vi gör” |
| Val av omfattning | Falsk fullständighet och överpackad omfattning | Behövs varje objekt verkligen för Sprint Goal? Vad kan tas bort först? |
| Teamets tillgängliga kapacitet | Missar verkliga avbrott, buggar, support och möten | Är semestrar, supportbelastning, oavslutat arbete, obligatoriska möten och väntan på externa beroenden beaktade |
| Beroenden | Modellen kan hitta på ett beroende som inte finns eller missa ett organisatoriskt | Alla externa beroenden är bekräftade av människor och har ansvariga |
| Nedbrytning | Teamet accepterar passivt någon annans uppdelningslogik | Uppdelningen speglar teamets arkitektur, risker och Definition of Done |
| Testning | Pseudotäckning: många tester men inte felmoderna | Finns det verifierbara acceptanskriterier, observerbarhet och testdata |
| Riskhantering | Listan ser fullständig ut och stänger ämnet | Vilka risker är inte bekräftade av fakta? Vilka kan minskas redan nu? |
| Teamets åtagande | Utdelning av ägande/ansvar: “planen är redan sammanställd” | Utvecklarna har uttryckligen bekräftat Sprint Backlog som sin plan |
| Dokumentation | I protokollet hamnar inte överenskommelser utan modellens övertygande formuleringar | Alla viktiga beslut, fakta och öppna frågor är bekräftade av deltagarna |
Det viktiga i den här tabellen är inte att AI “gör planning bättre”. Den mer träffsäkra tanken: AI snabbar nästan överallt upp sammanställningen av utkast, listor, alternativ och protokoll. Men nästan ingenstans ersätter det den sista mänskliga kontrollcykeln för faktakorrekthet, realism och ägande/ansvar.
Datahantering och datahygien: vad som inte tanklöst får ges till modellen
I planning uppstår ofta frestelsen att ladda in allt i AI: uppgifter i Jira, diskussionstrådar i Slack, kundärenden, supportloggar, delar av dokumentation, teamets kalender, incidenthistorik, korrespondens med intressenter. Ur planningkvalitetssynpunkt är det begripligt: ju mer kontext, desto bättre utkast.
Men ur governance-synpunkt är det farligt.
Om teamet använder AI för att förbereda Sprint Planning måste det i förväg komma överens om vilka data som får skickas till modellen och vilka som inte får det, vem som granskar resultatet och hur omtvistade punkter dokumenteras. Här fungerar ett enkelt governance-arbetssätt bra: uttryckligen utse ansvariga granskningar, skilja fakta från antaganden, dokumentera det okända, bevara viktiga manuella åsidosättanden från teamet ovanpå AI-rekommendationer och verifiera källor för centrala påståenden. I prompter / förfrågningar till modellen bör man inte tanklöst infoga:
- verkliga kundnamn;
- e-postadresser till användare och anställda;
- produktionsdata;
- detaljer om säkerhetsincidenter;
- inloggningsuppgifter, tokens, API-nycklar;
- fullständiga granskningsloggar;
- juridiska dokument och avtalsvillkor;
- HR-information;
- kommersiellt känsliga detaljer som inte behövs för planning.
Det är säkrare att arbeta med minimerad och avidentifierad kontext: ersätta verkliga identifierare med avidentifierade ersättare, använda redigering med borttagning av känsliga data / anonymisering, skicka aggregerade historiska mönster i stället för råa utdrag, skilja fakta från antaganden och dokumentera vilka prompter / förfrågningar till modellen och modellens svar som faktiskt användes vid förberedelsen av planning.
Det är inte byråkrati. Det är ett sätt att inte förvandla AI-assisted planning till en kanal för dataläckage och att inte ge modellen mer kontext än vad som behövs för det specifika beslutet.
Checklista: en AI-sammanställd Sprint Plan kan diskuteras om…
Denna checklista är inte en officiell Scrum-artefakt. Det är ett praktiskt filter som hjälper teamet att inte förväxla ett AI-utkast med en verklig plan.
En AI-sammansatt Sprint Plan kan diskuteras om:
- Sprint Goal är formulerat som ett värde eller ett förändrat tillstånd för användaren / intressenten, inte som en uppgiftslista.
- För varje valt backlog-objekt kan teamet förklara hur det stöder Sprint Goal.
- Teamets tillgängliga kapacitet har beaktats inte abstrakt, utan med hänsyn till semestrar, support, buggfixar, överföring av oavslutat arbete, onboarding och obligatoriska möten.
- Oavslutat arbete från föregående sprint är tydligt genomgånget: vad som flyttas över, vad som avbryts, vad som kräver omvärdering.
- Externa beroenden är explicit namngivna, var och en har en ansvarig och en tydlig status.
- För den valda arbetsvolymen ser teamet en väg till Definition of Done, inte bara till tillståndet "koden är nästan klar".
- Planen är testbar: det finns acceptanskriterier, negativa scenarier, gränsfall, observerbarhet och tydliga data för verifiering.
- Teamet kan med en enda mening ange den minsta värdefulla arbetsvolymen för sprinten.
- Teamet förstår i förväg vad som först kan tas bort från arbetsvolymen om ny information dyker upp.
- Väsentliga faktapåståenden från AI-utkastet har verifierats manuellt: statusar, beroenden, historiska data, arkitektoniska begränsningar, regler för deadline, lokalisering, deduplicering.
- Någon av deltagarna har specifikt försökt motbevisa AI-utkastet, inte bara förbättra det.
- Teamet har separat granskat var planen är för slät, för exakt eller misstänkt "självklar".
- Utvecklarna har explicit bekräftat att Sprint Backlog är deras plan och att Sprint Goal är teamets åtagande för sprinten.
- Resultatet av planning är dokumenterat så att det är tydligt: vad som beslutats, vad som antagits, vad som förblir okänt och vad som lagts utanför arbetsvolymen.
I praktiken kan denna checklista användas inte som en formell kontrollbarriär, utan som en kort tankedisciplin i slutet av planning. Särskilt användbara är två frågor: "vad i detta AI-utkast kan vara osant?" och "vad tar vi bort först om verkligheten visar sig vara svårare?".
Vad jag skulle rekommendera teamet
För det första, använd AI före Sprint Planning inte för att "den ska planera sprinten", utan för att den ska förbereda material för en bra mänsklig diskussion. Låt den samla varianter, beroenden, antaganden, risker, gränsfall, alternativa varianter av arbetsvolymen och frågor. Men beslutet ska stanna hos teamet.
För det andra, skilj alltid planutkastet från teamets åtagande. Ett AI-utkast kan vara ett utmärkt underlag, men Sprint Backlog blir verklig först när Utvecklarna förstår den som sin plan.
För det tredje, acceptera inte uppskattningar genererade av AI som mer objektiva bara för att de ser strukturerade ut. Replikationer och översikter av automatiserad uppskattning / uppskattning av arbetsinsats med AI-stöd ger tillräckligt underlag för försiktighet: en komplex modell blir inte bättre än en enkel basmodell bara på grund av sin komplexitet. I uppskattningar är inte bara felet farligt, utan även överdriven säkerhet. Det är bättre att använda AI för att identifiera osäkerheter än för att skapa en illusion av precision.
För det fjärde, dokumentera explicit vad som ligger utanför arbetsvolymen. I bra AI-assisted planning-sessioner skapas värde ofta inte bara genom det teamet valde, utan också genom det de medvetet inte tog med. I LMS-fallet kan det vara expireden fullständig instrumentpanel för kundsupportteamet, komplex segmentering av påminnelsers periodicitet och avancerad analys.
För det femte, utse ägare för verifieringen. Affärslogiken verifieras av Produktägaren, kravens sammanhang av analytikern, den arkitektoniska genomförbarheten av utvecklarna, testbarheten av QA, gränserna för användarupplevelsen av designern, kvaliteten på teamets överenskommelse av Scrum Mastern. AI kan förbereda ett gemensamt utkast, men kan inte äga verifieringen.
Slutsats
Om AI i Backlog Refinement hjälper till att snabbare samla och utforma material för diskussion, hjälper den i Sprint Planning till att snabbare samla planvarianter. Den kan föreslå en Sprint Goal, gruppera backlog-objekt, lyfta fram beroenden, skissa en nedbrytning, förbereda testscenarier, skriva ner antaganden och till och med snyggt dokumentera mötets resultat.
Men det gör inte planen realistisk.
En realistisk Sprint Plan uppstår först när teamet ärligt har verifierat värdet, arbetsvolymen, teamets tillgängliga kapacitet, beroenden, Definition of Done, testbarheten och sin egen beredskap att ta detta i arbete. AI kan påskynda denna verifiering, men kan inte ersätta den. Den kan hjälpa till att se fler varianter, men kan inte välja teamets åtagande åt människorna.
Därför skulle jag formulera AI:s huvudsakliga effekt i Sprint Planning så här: den sänker kostnaden för att förbereda planvarianter, men höjer priset för mänsklig verifiering. Ju enklare det blev att skapa en vacker plan, desto viktigare blev det att förstå om den är en verklig teamplan.
I ett moget team förvandlar AI inte Sprint Planning till automatisk generering av Sprint Backlog. Det förvandlar det till ett mer sakligt samtal om mål, begränsningar och avvägningar. Och det är kanske den mest användbara formen av automatisering: inte att ta bort människor från planning, utan att frigöra deras uppmärksamhet för de beslut som verktyget inte kan fatta åt dem.
Källor och riktmärken
- Scrum Guide 2020 — Sprint Planning, Sprint Goal, Sprint Backlog, ansvarsområden.
- NIST-ramverket för hantering av AI-risker 1.0 — styrning / reglering, ansvarsskyldighet / ansvar, konfiguration av människa-AI-interaktion.
- NIST-profil för generativ AI — konfabulation / säkerställd påhittning, överdrivet beroende, integritet och riskhantering.
- ChatGPT as a tool for User Story Quality Evaluation — exempel på måttlig evidensbas för uppgifter om kvalitet på användarberättelser.
- Large Language Models for Software Engineering: Survey and Open Problems — översikt av LLM inom mjukvaruutveckling / programvaruteknik.
- Arbetsinsatsuppskattning i Agile mjukvaruutveckling: en systematisk litteraturöversikt — kvalitetsfaktorer för Agile-uppskattning.
- Reasons and Approaches for Accurate Effort Estimations in Agile Iterative Development — informationskvalitet, team, uppskattningspraxis, projektledning, affärspåverkan.
- GPT2SP replication report — begränsningar för AI-uppskattning i story points och jämförelse med enkla basmodeller / riktmärken.
- Mot tillförlitlig iterativ Agile-planering genom att förutsäga dokumentationsändringar i arbetsobjekt — sambandet mellan dokumentationsändringar och planningens bräcklighet.
- The Planning Fallacy — klassiskt arbete om underskattning av tidsramar.
- Automation Bias in Intelligent Time Critical Decision Support Systems — automatiseringsbias, utelämnandefel och åtgärdsfel.
- Generalization bias in large language model summarization — risk för överdrivna generaliseringar i sammanfattningar skapade av stora språkmodeller.
- OWASP Top 10 för LLM-applikationer — känslig information, överdrivet beroende, risker med promptar och säkerhet.