
Sprint Retrospective และ AI: ทำไมการปรับปรุงจึงมอบหมายให้โมเดลไม่ได้
AI เปลี่ยน Sprint Retrospective อย่างไร: ที่ใดที่มันรวบรวมสัญญาณเกี่ยวกับกระบวนการ ทำไมมันจึงไม่แทนที่การสนทนาที่ซื่อสัตย์ และจะหลีกเลี่ยงการเปลี่ยนเรโทรให้กลายเป็นคำแนะนำจาก AI ได้อย่างไร
 ไม่สามารถโหลดภาพนี้ได้
นี่คือบทความชิ้นที่ห้าในซีรีส์ว่าด้วยวิธีที่ AI เปลี่ยนการประชุมแบบคลาสสิกของทีมพัฒนาข้ามสายงาน ในตอนก่อน ๆ ผมได้วิเคราะห์ Backlog Refinement, Sprint Planning, Daily Scrum และ Sprint Review. ข้อสรุปโดยรวมค่อย ๆ ชัดเจนขึ้นเรื่อย ๆ ว่า AI เก่งในการรวบรวมข้อมูลป้อนเข้าสู่การสนทนา แต่ไม่ควรเข้าแทนที่ตัวการสนทนาเอง ใน Sprint Retrospective เส้นแบ่งนี้สำคัญเป็นพิเศษ เพราะที่นี่ทีมไม่ได้พูดคุยแค่เรื่องงานและผลิตภัณฑ์ แต่ยังรวมถึงนิสัยของตัวเอง ปฏิสัมพันธ์ คุณภาพ และความสามารถในการเปลี่ยนแปลง
Sprint Retrospective ดูเหมือนเป็นตัวเลือกที่เหมาะกับ AI มาก ในช่วงท้ายสปรินต์มีข้อมูลอยู่แล้วทั้ง Jira, Git, pull requests, CI/CD, เหตุการณ์ผิดปกติ, แชต, ปฏิทิน, บันทึกจาก Daily Scrum, การตัดสินใจจาก Sprint Review และบางครั้งยังมีแบบสำรวจสั้น ๆ ของทีม โมเดลสามารถรวบรวมได้อย่างรวดเร็วว่า: อะไรที่ทำให้งานช้าบ่อยที่สุด, review bottlenecks ไปค้างอยู่ที่ไหน, งานใดถูกเลื่อนข้ามวันแล้ววันเล่า, Definition of Done จุดไหนยังไม่ชัดเจน, การตัดสินใจใดถูกพูดซ้ำ, หัวข้อใดที่เคยปรากฏในเรโทรครั้งก่อนและยังไม่หายไป
เมื่อมองแวบแรก นี่เกือบจะเป็นการทำงานอัตโนมัติที่สมบูรณ์แบบ ไม่ต้องพยายามนึกถึงสปรินต์ทั้งหมดใหม่ ไม่ต้องเถียงกันว่าการรอ review เป็นปัญหาจริงหรือเป็นแค่ความรู้สึกของใครคนหนึ่ง ไม่ต้องไล่ดูตั๋วและเธรดการสนทนานับสิบด้วยมือ AI สามารถเตรียมข้อเท็จจริง จัดกลุ่มรูปแบบที่เกิดซ้ำ เสนอการวิเคราะห์สาเหตุราก และแม้แต่สร้าง action items สำหรับสปรินต์ถัดไปได้
แต่ความเสี่ยงหลักก็เริ่มต้นขึ้นตรงนี้แหละ
Sprint Retrospective ไม่ได้มีอยู่เพื่อให้ได้รายการปรับปรุงที่เรียบร้อย ความหมายของมันคือการที่ทีมได้เห็นอย่างซื่อสัตย์ว่าตัวเองทำงานอย่างไร ตกลงกันว่าควรเปลี่ยนอะไร และรับผิดชอบต่อการเปลี่ยนแปลงนั้น หาก AI เปลี่ยนเรโทรให้กลายเป็นรายการคำแนะนำ ทีมอาจได้เอกสารที่สวยงามแต่สูญเสียสิ่งสำคัญที่สุดไป นั่นคือความปลอดภัยทางจิตใจ ความเข้าใจปัญหาร่วมกัน และการลงมือทำต่อเนื่องอย่างแท้จริง
“AI สามารถชี้ให้เห็นรูปแบบได้ แต่การปรับปรุงจะเริ่มต้นก็ต่อเมื่อทีมยอมรับปัญหาและเปลี่ยนพฤติกรรมของตัวเอง”
ทำไมจึงต้องมี Sprint Retrospective
ใน Scrum Guide 2020 นั้น Sprint Retrospective ถูกอธิบายไว้อย่างเป็นรูปธรรมมาก: ทีมวางแผนวิธีเพิ่มคุณภาพและประสิทธิผล ในการนี้ Scrum Team ตรวจสอบว่าสปรินต์ผ่านไปอย่างไรในแง่ของผู้คน ปฏิสัมพันธ์ กระบวนการ เครื่องมือ และ Definition of Done ทีมพูดคุยว่าอะไรผ่านไปด้วยดี มีปัญหาใดเกิดขึ้น และปัญหาเหล่านั้นได้รับการแก้ไขหรือไม่ จากนั้นจึงกำหนดการเปลี่ยนแปลงที่เป็นประโยชน์ที่สุด โดยการปรับปรุงที่สำคัญที่สุดต้องได้รับการจัดการโดยเร็วที่สุดและอาจถูกนำเข้า Sprint Backlog ของสปรินต์ถัดไป
นั่นหมายความว่าเรโทรสเปกทีฟไม่ใช่การระบายอารมณ์ตอนท้ายสปรินต์ และไม่ใช่พิธีกรรมที่เป็นทางการซึ่งต้องกรอกสามคอลัมน์: อะไรดี อะไรแย่ อะไรจะปรับปรุง มันคือกิจกรรมเกี่ยวกับการปรับตัวของวิธีการทำงาน ในแง่นี้มันเชื่อมโยงโดยตรงกับตรรกะโดยรวมของ Scrum: ความโปร่งใสจำเป็นต่อการตรวจสอบ การตรวจสอบจำเป็นต่อการปรับตัว และการตรวจสอบที่ไม่มีการปรับตัวก็กลายเป็นเรื่องว่างเปล่า Scrum Guide เน้นชัดเจนว่าเหตุการณ์ต่าง ๆ ใน Scrum ถูกออกแบบมาเพื่อกระตุ้นการเปลี่ยนแปลง ไม่ใช่แค่ผลิตเอกสารบันทึก
ในฐานะแนวทางเสริม Scrum Guide Expanded v2026.1มีประโยชน์ แต่ในฐานะแหล่งอ้างอิงประกอบที่อิงจาก Scrum Guide 2020 ไม่ใช่ฉบับมาตรฐานใหม่ของ Scrum Guide สำหรับบทความนี้มันสำคัญด้วยสองเรื่อง อย่างแรก มันกล่าวว่าการสะท้อนคิดมีประสิทธิผลกว่าในสภาพแวดล้อมที่ปลอดภัยทางจิตใจ อย่างที่สอง ในส่วนเกี่ยวกับ AI มันอธิบายโมเดลว่าเป็นหุ้นส่วนการตัดสินใจภายใต้การกำกับดูแล: AI สามารถเสริมความโปร่งใส การตรวจสอบ และการปรับตัว แต่ไม่แทนที่ความรับผิดชอบของมนุษย์ และไม่ยกเลิกการควบคุมกระบวนการเชิงประจักษ์
ดังนั้นผมจึงอธิบายจุดประสงค์ของ Sprint Retrospective ผ่านห้าหน้าที่:
- เห็นรูปแบบการทำงานจริงของทีม ไม่ใช่แค่ความคิดเห็นที่เสียงดังที่สุด;
- พูดคุยเรื่องปฏิสัมพันธ์ กระบวนการ เครื่องมือ และ Definition of Done โดยไม่กลัวการลงโทษ;
- แยกข้อเท็จจริงออกจากการตีความและการคาดเดา;
- เลือกการปรับปรุงจำนวนน้อยที่ทีมพร้อมจะลองจริง ๆ;
- ย้ายการปรับปรุงเหล่านั้นเข้าสู่สปรินต์ถัดไปโดยมี owner เกณฑ์การตรวจสอบ และที่อยู่ในงาน
นี่คือกรอบสำหรับการสนทนาเกี่ยวกับ AI หากเครื่องมือช่วยให้ทีมทำหน้าที่เหล่านี้ได้ดีขึ้น มันก็มีประโยชน์ หากมันเพียงสร้างรายการ action items ที่สวยงามขึ้น มันอาจสะดวก แต่ไม่ได้ทำให้ทีมมีประสิทธิผลมากขึ้นเสมอไป
อะไรที่มักจะผิดพลาด
ปัญหาของ retrospective ไม่ค่อยอยู่ที่ทีมไม่สามารถระบุปัญหาได้ ปัญหามักเป็นอย่างอื่น ทีมกลับมาพูดคุยเรื่องเดิมซ้ำแล้วซ้ำเล่า Action items ย้ายจาก sprint หนึ่งไปยังอีก sprint หนึ่ง ผู้คนพูดอย่างระมัดระวังเพราะไม่อยากดูเหมือนเป็นผู้ผิด หัวข้อที่เจ็บปวดที่สุดถูกเลี่ยงไป Scrum master ดึงรูปแบบออกมาได้ แต่ดึงการเปลี่ยนแปลงออกมาไม่ได้ ในตอนท้ายทุกคนเห็นด้วยกับอะไรทำนองว่า "มาสื่อสารกันให้ดีขึ้นเถอะ" และสิ่งนั้นก็จางหายไปแล้วในสัปดาห์ถัดมา
งานวิจัยของ Lehtinen, Itkonen และ Lassenius ใน Empirical Software Engineering ได้เน้นด้านนี้ของ retrospective ได้เป็นอย่างดี ผู้เขียนศึกษา team-level retrospective 37 ครั้งในช่วงเกือบสามปี และแสดงให้เห็นสิ่งสำคัญหลายอย่าง: การอภิปรายมักเกี่ยวกับหัวข้อที่ใกล้ตัวและทีมจัดการได้ แต่也可能มี participant bias; หากไม่มี hard evidence ก็ไม่ всегдаสะท้อนความเป็นจริง; บางหัวข้อถูกพูดซ้ำเป็นเวลานาน เพราะ要么กลับมาเองตามธรรมชาติ要么ทีมไม่สามารถแก้ไขได้ในระดับของตนเนื่องจากความซับซ้อนหรือการขาดการควบคุม
นี่เป็นกรอบที่มีประโยชน์มากสำหรับ AI โมเดลสามารถช่วยนำ hard evidence มาสู่จุดที่เมื่อก่อนมีเพียงความรู้สึกได้จริง ตัวอย่างเช่น ทีมพูดว่า "review ทำให้ sprint ช้าลง" AI สามารถยกข้อเท็จจริงขึ้นมาได้: มี PR กี่รายการที่รอเกินหนึ่งวัน รายการใดบ้างที่ค้างอยู่ ความคิดเห็นใดถูกพูดซ้ำ มีการแก้ไขหลัง merge ที่ไหน นี่มีประโยชน์กว่าการโต้เถียงจากความทรงจำ
แต่กรอบเดียวกันนี้ก็มีอีกด้านหนึ่ง หากทีมไม่อยากพูดถึงสาเหตุที่ไม่สบายใจ AI ก็ไม่ทำให้ทีมซื่อสัตย์ขึ้นได้ หากปัญหาอยู่นอกเหนือขอบเขตอิทธิพลของทีม โมเดลอาจกำหนด action item ได้อย่างสวยงามแต่ก็ยังไม่มีใครทำอยู่ดี หากผู้คนไม่ไว้วางใจบริบท พวกเขาจะโต้เถียงไม่ใช่เกี่ยวกับกระบวนการอีกต่อไป แต่เกี่ยวกับว่า AI อธิบายงานของพวกเขาถูกต้องหรือไม่
AI ช่วยได้จริงตรงไหน
AI มีพื้นที่ประโยชน์ที่แข็งแกร่งใน Sprint Retrospective หากไม่พยายามมอบหมายการปรับปรุง本身ให้มัน ผมจะใช้มันก่อน retro และหลัง retro ไม่ใช่แทน retro
แต่สิ่งสำคัญคืออย่าสัญญาเกินจริง DORA State of AI-assisted Software Development 2025 อธิบาย AI ว่าเป็นตัวเสริมกำลังของจุดแข็งและจุดอ่อนที่มีอยู่ของระบบองค์กร สำหรับ retrospective นี่เกือบเป็นถ้อยคำที่สมบูรณ์แบบ: หากทีมสามารถอภิปรายกระบวนการอย่างซื่อสัตย์และนำการปรับปรุงไปสู่การปฏิบัติได้อยู่แล้ว AI จะทำให้ข้อมูลนำเข้ามีความสมบูรณ์ยิ่งขึ้น หาก retro กลายเป็นพิธีกรรมที่ปลอดภัยโดยไม่มีการติดตามผลมานานแล้ว AI ก็เพียงทำให้พิธีกรรมนี้เร็วขึ้นและเรียบร้อยขึ้นเท่านั้น
ก่อนการประชุม AI สามารถเตรียมข้อมูลนำเข้าสำหรับการตรวจสอบ:
- รวบรวม impediments ที่เกิดซ้ำจาก Daily Scrum, tickets, pull requests และ incident notes;
- ค้นหาจุดที่ work items รอนานสำหรับ review, ข้อมูลทดสอบ, การตัดสินใจของ Product Owner หรือ dependency ภายนอก;
- เปรียบเทียบแผนกับ Sprint Planning, การตัดสินใจจริงระหว่าง sprint และผลลัพธ์ที่อภิปรายใน Sprint Review;
- เน้นความไม่สอดคล้องระหว่าง Definition of Done กับวิธีที่ทีมปิดงานจริง;
- รวบรวม action items เก่าและแสดงว่าอันใดเสร็จแล้ว ถูกลืม หรือเกิดซ้ำ;
- กำหนดคำถามที่เป็นไปได้สำหรับการสนทนา: อะไรคือข้อเท็จจริง อะไรคือการตีความ และอะไรต้องตรวจสอบ
หลังการประชุม AI สามารถช่วยเรื่องการติดตามผล: บันทึก action items ที่เลือกอย่างเรียบร้อย เพิ่ม owner เกณฑ์การตรวจสอบ ความเชื่อมโยงกับ Sprint Backlog และการเตือนสำหรับ retrospective ครั้งถัดไป สิ่งนี้มีค่าอย่างยิ่งเพราะจุดอ่อนของ retro หลายแห่งไม่ได้อยู่ที่การอภิปราย แต่อยู่ที่การปรับปรุงไม่รอดไปถึง sprint ถัดไป
แต่ในทุกสถานการณ์เหล่านี้ AI ยังคงเป็นชั้นเตรียมการและสนับสนุน มันไม่ควรตัดสินว่าปัญหาใดสำคัญที่สุด มันไม่ควรระบุผู้ผิด มันไม่ควรกำหนด root cause เป็นข้อเท็จจริง และแน่นอนมันไม่ควรเขียน "แผนการปรับปรุงของทีม" โดยอัตโนมัติโดยไม่มีการตรวจสอบจากคนจริง
ทำไม AI ไม่ควรทำ retrospective แทนทีม
เวอร์ชันที่อันตรายที่สุดของ AI-assisted Retrospective ดูเหมือนจะโตเต็มที่ โมเดลรวบรวมข้อมูลทั้งหมด วิเคราะห์อารมณ์ของทีม ค้นหา "สาเหตุหลักสามประการของปัญหา" เสนอ action items และส่งสรุปไปยัง Slack หรือ Confluence ทุกคนอ่าน พยักหน้า กดรีแอ็กชัน และ retro ก็สั้นลง บางครั้งทีมเริ่มคิดว่า: หาก AI วิเคราะห์ทุกอย่างแล้ว ทำไมต้องเสียเวลาหนึ่งชั่วโมงมาคุยกัน?
ปัญหาคือ retrospective มีค่าไม่เพียงเพราะข้อสรุป มันมีค่าเพราะกระบวนการทำความเข้าใจร่วมกัน ทีมไม่เพียงต้องการได้รับข้อความว่า "review ใช้เวลานานเกินไป" แต่ต้องตกลงกันว่าทำไมสิ่งนี้จึงเกิดขึ้น ทีมพร้อมจะเปลี่ยนอะไร ยอมรับการประนีประนอมใด และใครรับผิดชอบการดำเนินการ บางครั้งในการสนทนานี้สิ่งที่ไม่เห็นจากข้อมูลก็ผุดขึ้นมา: ความกลัวที่จะโต้แย้งกับนักพัฒนาที่แข็งแกร่ง ความหงุดหงิดจาก product context ที่ไม่ชัดเจน ความเหนื่อยล้าจากงานเร่งด่วนตลอดเวลา ความไม่เห็นด้วยอย่างเงียบ ๆ กับ Definition of Done ปัจจุบัน
งานคลาสสิกของ Amy Edmondson เกี่ยวกับ psychological safety и learning behavior важна здесь не как модная ссылка, а как практический ориентир. Если люди не чувствуют, что могут говорить о проблемах без межличностного риска, ретроспектива превращается в безопасные формулировки. AI в такой ситуации может сделать протокол более гладким, но не сделать команду честнее.
Более того, AI может ухудшить честность, если команда воспринимает его как мониторинг. Если модель читает Slack, Jira, PR-комментарии и календарь, а потом пишет «у Алексея низкая скорость реакции на review» или «QA часто задерживает готовность данных», это уже не поддержка ретроспективы. Это performance management под видом улучшения процесса. В такой среде люди начинают оптимизировать видимую активность, спорить с моделью и защищать репутацию вместо того, чтобы обсуждать реальный процесс.
Именно поэтому источники вроде NIST Generative AI Profile, OWASP Top 10 for LLM Applications 2025, EDPB Opinion 28/2024 и материалы ICO по monitoring at work здесь релевантны. Не как юридический раздел статьи, а как напоминание: ретроспективные данные легко становятся чувствительными. Они касаются людей, поведения, конфликтов, ошибок, задержек, переписки и иногда слабых мест управления.
Практическая граница простая: AI в ретро должен анализировать work and system, not people. То есть застрявшую работу, повторяющиеся ожидания, неясные правила, пробелы в Definition of Done, плохие handoffs, перегруженные точки процесса. Не «кто плохо работал», а «что в системе заставляет нас снова приходить к этому же результату».
“Хороший AI-input для ретро смотрит на застрявшую работу и повторяющиеся паттерны. Плохой AI-input превращает людей в строки отчёта.”
Продолжим кейс: B2B LMS и email-напоминания
Возьмём тот же кейс из предыдущих статей: B2B LMS-платформа, обязательные курсы, email-напоминания сотрудникам, не завершившим обязательный курс до дедлайна. На Sprint Planning команда выбрала узкий Sprint Goal: система отправляет одно корректное напоминание активным сотрудникам с незавершённым обязательным курсом до дедлайна и сохраняет проверяемую историю отправки. На Daily Scrum команда отслеживала риски по дедупликации, часовым поясам и тестовым данным. На Sprint Review команда обсуждала, что это меняет для продукта и Product Backlog.
Теперь наступает Sprint Retrospective. Без AI разговор может быстро уйти в привычные ощущения. Бэкенд говорит: «нас тормозили уточнения eligibility». QA говорит: «тестовые данные пришли поздно». Фронтенд говорит: «API менялся в середине спринта». Владелец продукта говорит: «мы не ожидали столько вопросов по expired». Скрам-мастер записывает: «улучшить коммуникацию», «раньше готовить данные», «меньше менять требования». Вроде бы ретро проведено.
AI может сделать вход предметнее. Он поднимает историю спринта и показывает:
- четыре PR ждали review больше суток, и все были связаны с retry logic и idempotency;
- трижды менялась трактовка eligibility для деактивированных пользователей;
- QA data появилась на третий день позже, чем команда ожидала на planning;
- Definition of Done не требовала проверяемой истории отправки для негативных сценариев;
- старый action item «уменьшить размер PR» не был выполнен и повторился как проблема;
- часть обсуждений в Slack была не про реализацию, а про отсутствие единого решения по
expired.
Это хороший вход. Но это ещё не ретроспектива.
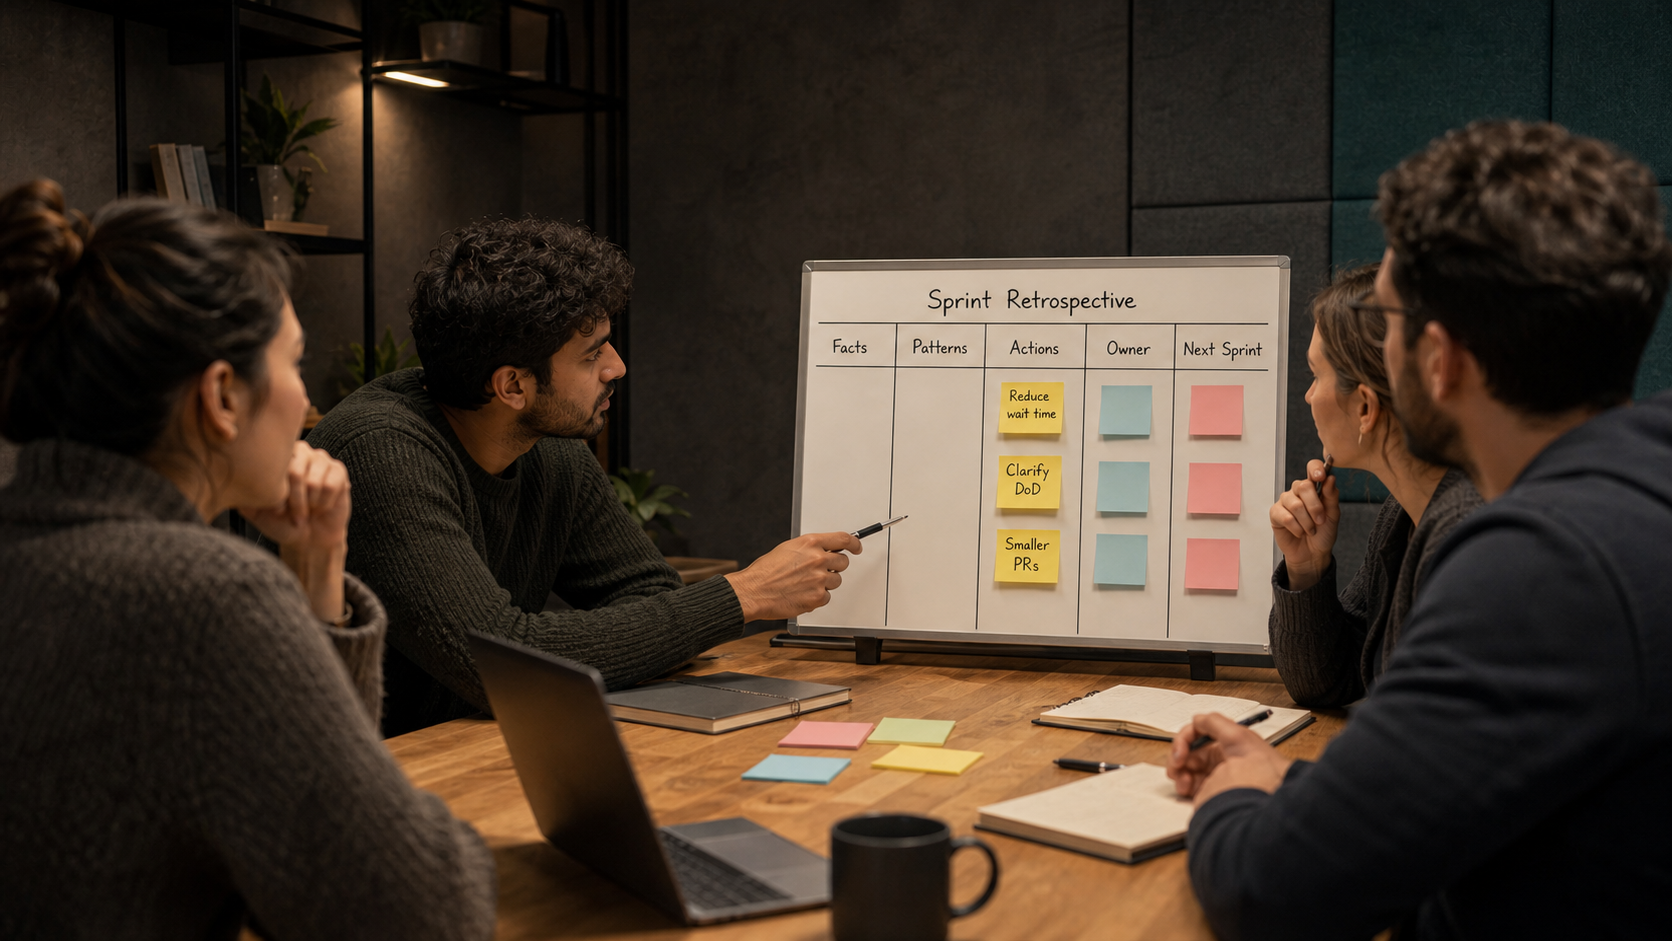
Ретроспектива начинается, когда команда обсуждает, что из этого действительно менять. Например, она может решить: не «раньше коммуницировать», а «на planning явно фиксировать спорные состояния eligibility и их product owner decision». Не «QA быстрее готовит данные», а «в Sprint Backlog добавляется отдельный work item на тестовые данные до начала реализации критичного сценария». Не «делать меньше PR», а «для изменений в notification architecture PR должен помещаться в один review-сценарий и иметь owner по review до начала работы». Не «улучшить DoD», а «Definition of Done теперь включает проверяемую историю отправки для негативных сценариев напоминаний».
Вот это уже action items. Они конкретные, проверяемые и связаны со следующим спринтом. AI помог увидеть паттерны. Команда выбрала изменение.
Anti-patterns
Ниже — несколько анти-паттернов, которые я бы отдельно отслеживал при внедрении AI в Sprint Retrospective.
1. AI-резюме заменяет живой разговор
Если команда просто читает сгенерированное резюме и соглашается с ним, ретро теряет главное. Хороший вопрос не «точно ли AI описал спринт?», а «что из этого мы готовы изменить в нашей работе?».
2. Sentiment analysis превращается в правду о команде
Анализ тональности может быть полезным слабым сигналом, но он не знает контекста. Сарказм, усталость, локальный конфликт, шутка, молчание и осторожная формулировка плохо превращаются в метрику. Настроение команды нельзя сводить к графику.
3. AI ищет виновных вместо системных паттернов
เมื่อโมเดลเริ่มจัดอันดับผู้คนตามความเร็ว กิจกรรม หรือจำนวน "blocker ที่สร้างขึ้น" การทบทวนย้อนหลังก็กลายเป็นการเฝ้าติดตาม สิ่งนี้ทำลายความปลอดภัยทางจิตใจและลดคุณภาพของข้อมูลที่ผู้คนยินดีจะนำมาแบ่งปัน
4. Root cause ถูกยอมรับโดยไม่มีการตรวจสอบ
โมเดลอาจเขียนอย่างมั่นใจว่า "สาเหตุหลักของความล่าช้าคือข้อกำหนดที่ไม่ชัดเจน" แต่นี่อาจเป็นเพียงส่วนที่มองเห็นได้ สาเหตุที่แท้จริงอาจอยู่ที่ architectural debt ความขัดแย้งของลำดับความสำคัญ การขาดข้อมูลทดสอบ หรือความกลัวที่จะยกระดับปัญหา Root cause จาก AI คือสมมติฐาน ไม่ใช่ข้อเท็จจริง
5. Action items กลายเป็นเรื่องกว้างเกินไป
"ปรับปรุงการสื่อสาร" "review ให้เร็วขึ้น" "เตรียมตัวให้ดีขึ้น" แทบไม่เคยเปลี่ยนพฤติกรรม Action item ที่ดีต้องตอบคำถามว่า ใครทำ อะไรที่เปลี่ยนแปลงจริง เห็นได้ที่ไหนในสปรินต์ถัดไป และทีมจะตรวจสอบผลลัพธ์อย่างไร
6. การปรับปรุงไม่เข้าสู่ Sprint Backlog
Scrum Guide อนุญาตให้การปรับปรุงที่สำคัญที่สุดเข้าสู่ Sprint Backlog ของสปรินต์ถัดไป หากทีมเลือกการปรับปรุงแล้วแต่ไม่ได้จัดสรรความสนใจ owner และพื้นที่ในงานให้ นั่นไม่ใช่ improvement นั่นคือความปรารถนา
บทบาทเปลี่ยนไปอย่างไร
AI ไม่ได้ยกเลิกขอบเขตความรับผิดชอบภายใน Scrum Team แต่เปลี่ยนการเตรียมตัวสำหรับการสนทนา คุณค่าของการฟื้นฟูประวัติสปรินต์ด้วยมือลดลง คุณค่าในการตีความอย่างซื่อสัตย์ การเลือกการทดลองเล็กๆ และการผลักดันการปรับปรุงให้เกิดผลลัพธ์เพิ่มขึ้น
| บทบาท | ความเสี่ยงในสถานการณ์ AI ที่ไม่ดี | การใช้ AI อย่างมีวุฒิภาวะ |
|---|---|---|
| นักพัฒนา | โต้เถียงกับ AI ที่ประเมินกิจกรรมของตนและปกป้องชื่อเสียงแทนที่จะอภิปรายกระบวนการ | ใช้ข้อเท็จจริงและรูปแบบเป็นข้อมูลนำเข้า แต่เลือกเองว่าจะเปลี่ยนอะไรในแนวปฏิบัติทางวิศวกรรม review DoD และ handoffs |
| เจ้าของผลิตภัณฑ์ | อ่าน AI-retro เป็นรายงานประสิทธิภาพของทีมและกดดันเรื่องความเร็ว | ช่วยขจัดความคลุมเครือของผลิตภัณฑ์ ชี้แจงการตัดสินใจที่ทำให้ทีมชะงัก และสนับสนุนการปรับปรุงใน Sprint Backlog ถัดไป |
| Scrum Master | มอบการอำนวยความสะดวกให้โมเดลและได้โปรโตคอลที่เรียบร้อยแทนการสนทนาอย่างซื่อสัตย์ | ใช้ข้อมูลนำเข้าจาก AI เพื่อเตรียมตัว แต่ปกป้องความปลอดภัยทางจิตใจ โฟกัสที่ระบบ และการติดตาม action items ที่เลือกไว้ให้สำเร็จ |
| วิศวกรคุณภาพ / QA | ได้รับบทบาท "แหล่งของความล่าช้า" หากโมเดลเชื่อมปัญหากับการทดสอบอย่างผิวเผิน | ช่วยแปลงสัญญาณคุณภาพให้เป็นการเปลี่ยนแปลง Definition of Done ความเป็นเจ้าของข้อมูลทดสอบ และ observability |
| นักออกแบบ UX/UI | หลุดออกจาก retro เพราะ AI วิเคราะห์โค้ด PR และงานพัฒนาส่วนใหญ่ | เน้นย้ำปฏิสัมพันธ์ การตัดสินใจ และบริบทของผู้ใช้ที่ส่งผลต่อคุณภาพงานของทีมและผลิตภัณฑ์ |
| Engineering Lead / Tech Lead | ใช้ AI-retro เป็นแดชบอร์ดควบคุมวิศวกร | ช่วยแยกแยะ engineering bottleneck เชิงระบบจากกิจกรรมส่วนบุคคล และเลือกการปรับปรุงทางเทคนิคที่ใส่ลงในสปรินต์ถัดไปได้จริง |
ตัวกรองเชิงปฏิบัติสำหรับ AI-assisted Retrospective
ผมคงไม่เริ่มจากแนวคิด "ให้ AI นำ retro" ผมคงเริ่มจากคำถามที่แคบกว่า: ข้อมูลนำเข้าแบบใดจะช่วยให้ทีมตรวจสอบวิธีการทำงานอย่างซื่อสัตย์ยิ่งขึ้นและเลือกการปรับปรุงหนึ่งหรือสองอย่างที่ทีมจะทำจริง?
ข้อมูลนำเข้าจาก AI สู่ Sprint Retrospective มีประโยชน์หากช่วยตอบคำถามเหล่านี้:
- ปัญหาใดเกิดขึ้นซ้ำ และสิ่งใดเกิดขึ้นครั้งเดียว;
- ข้อเท็จจริงใดยืนยันหัวข้อ และสิ่งใดเป็นความเห็นหรือการประเมินทางอารมณ์;
- สิ่งใดอยู่ในขอบเขตอิทธิพลของทีม และสิ่งใดต้องการความช่วยเหลือจาก Supporters ผู้บริหาร หรือทีมอื่น;
- action items เก่าใดที่ไม่ได้ทำและเพราะอะไร;
- กระบวนการ เครื่องมือ working agreement หรือ Definition of Done ใดที่ควรเปลี่ยนในสปรินต์ถัดไป;
- ทีมจะตรวจสอบได้อย่างไรว่าการเปลี่ยนแปลงได้ผล
และในทางกลับกัน หากข้อมูลนำเข้าจาก AI ตอบคำถาม "ใครคือคอขวด" เป็นหลัก นั่นคือสัญญาณอันตราย การทบทวนย้อนหลังควรช่วยให้ทีมปรับปรุงระบบการทำงาน ไม่ใช่สร้างการจัดอันดับสมาชิกแบบซ่อนเร้น
ข้อมูลและขอบเขต
Sprint Retrospective มีความอ่อนไหวต่อข้อมูลเป็นพิเศษ เพราะ AI เริ่มรวบรวมสิ่งที่ผู้คนรับรู้ว่าเป็นเรื่องส่วนตัวได้ง่าย: ข้อความในแชท ความเร็วในการตอบ น้ำเสียงของความคิดเห็น เวลาตอบสนองต่อ PR การมีส่วนร่วมในการประชุม ข้อผิดพลาดที่เกิดซ้ำ ความขัดแย้งในการอภิปราย ยิ่งเข้าถึงกว้าง การวิเคราะห์ก็ยิ่งน่าเชื่อถือ แต่ความเสี่ยงต่อการรั่วไหลของบริบทที่อ่อนไหว การพึ่งพาผลลัพธ์ของโมเดลมากเกินไป และการเปลี่ยน retro เป็น employee monitoring ก็ยิ่งสูงขึ้น
ในทางปฏิบัติ ผมคงกำหนดกฎหลายข้อก่อนนำ AI เข้าสู่ retro:
- ใช้ชุดแหล่งข้อมูลขั้นต่ำที่จำเป็นสำหรับคำถามของ retro;
- ไม่วิเคราะห์ข้อความส่วนตัวโดยไม่มีความตกลงและความจำเป็นชัดเจน;
- ไม่สร้างการจัดอันดับส่วนบุคคล score และข้อสรุปเกี่ยวกับ performance management;
- แสดงให้ทีมเห็นว่าข้อมูลใดถูกใช้และข้อมูลใดถูกตัดออก;
- แยกข้อเท็จจริงออกจากการตีความที่สร้างขึ้น;
- ตรวจสอบข้อสรุปสำคัญกับแหล่งข้อมูลต้นฉบับ;
- ลบหรือจำกัดการเก็บ AI summary หากมีบริบทของทีมที่อ่อนไหว
นี่ไม่ใช่ระบบราชการ นี่คือเงื่อนไขของการสนทนาที่ซื่อสัตย์ หากผู้คนไม่เข้าใจว่าโมเดลอ่านอะไรและผลลัพธ์ของมันถูกนำไปใช้อย่างไรในภายหลัง พวกเขาจะพูดอย่างระมัดระวังมากขึ้น และการมองย้อนอดีตอย่างระมัดระวังมักให้การปรับปรุงที่ปลอดภัยแต่Weak
ดังนั้นสิ่งที่เปลี่ยนไปจริงๆ
AI สามารถทำให้ Sprint Retrospective มีประโยชน์มากขึ้นได้จริง มันสามารถลดต้นทุนการเตรียมการ นำข้อเท็จจริงเข้าสู่การสนทนา แสดงรูปแบบที่เกิดซ้ำ เตือนเกี่ยวกับ action items ที่ยังไม่ได้ทำ เน้นความไม่สอดคล้องกับ Definition of Done และช่วยเปลี่ยนคำว่า "ต้องปรับปรุง" ที่คลุมเครือให้เป็น next-sprint experiment ที่ konkret
แต่มันจะได้ผลก็ต่อเมื่อทีมเข้าใจขอบเขต: AI เตรียมวัสดุสำหรับการตรวจสอบ ไม่ได้ทำการปรับตัวแทนทีม มันช่วยให้เห็นข้อมูล แต่ไม่ได้สร้างความปลอดภัยทางจิตใจ มันสามารถเสนอ root cause ได้ แต่ไม่รู้ว่าผู้คนกลัวที่จะพูดถึงอะไร มันสามารถเขียน action item ได้ แต่ไม่ได้เป็นเจ้าของและไม่ได้เปลี่ยนพฤติกรรมในสปรินต์ถัดไป
ดังนั้นวิทยานิพนธ์หลักที่ฉันจะกำหนดคือ: AI ควรลดต้นทุนในการฟื้นคืนข้อเท็จจริง เพื่อให้ทีมมีสมาธิมากขึ้นกับการสนทนาที่ซื่อสัตย์และการเลือกการปรับปรุงเล็กๆ น้อยๆ หากเกิดตรงกันข้ามและ Sprint Retrospective กลายเป็นรายการคำแนะนำที่สร้างขึ้นโดยอัตโนมัติ ทีมจะสูญเสียสิ่งที่เหตุการณ์นี้มีอยู่เพื่อ: การเรียนรู้ร่วมกัน ความรับผิดชอบต่อการเปลี่ยนแปลง และความสามารถในการยกระดับคุณภาพงาน
ทีมที่เติบโตเต็มที่ไม่ถามว่า: "เราสามารถมอบหมายให้ AI ดำเนินการย้อนอดีตได้หรือไม่?" พวกเขาถามแตกต่างออกไป: "AI สามารถรับส่วนใดของการเตรียมการได้บ้าง เพื่อให้การย้อนอดีตของเราซื่อสัตย์มากขึ้น konkretมากขึ้น และนำไปสู่การปฏิบัติได้ดีขึ้น?" นี่เป็นคำถามที่ดูไม่น่าตื่นเต้นนัก แต่ก็เป็นคำถามที่ใกล้เคียงกับการปรับปรุงอย่างต่อเนื่องที่แท้จริงมากกว่า
แหล่งที่มาและแนวทาง
- Scrum Guide 2020 — Sprint Retrospective, คุณภาพและประสิทธิภาพ, ผู้คน / การมีปฏิสัมพันธ์ / กระบวนการ / เครื่องมือ / Definition of Done, การปรับปรุงที่มีประโยชน์ที่สุด และความเชื่อมโยงกับ Sprint Backlog
- Scrum Guide Expanded v2026.1 — แหล่งข้อมูลเสริมจาก Scrum Guide 2020: psychological safety, meaningful continuous improvement follow-through และ AI ในฐานะ supervised decision-making partner
- Scrum.org: Introduction to the Sprint Retrospective — คำอธิบายเชิงปฏิบัติของ Sprint Retrospective ในฐานะเหตุการณ์สำหรับการตรวจสอบและปรับตัวของแนวปฏิบัติการทำงานของทีม
- Lehtinen, Itkonen & Lassenius: Recurring opinions or productive improvements — การศึกษาเชิงประจักษ์ของการย้อนอดีต 37 ครั้งในช่วงเกือบสามปี: participant bias, hard evidence, recurring topics และ corrective actions
- Amy Edmondson: Psychological Safety and Learning Behavior in Work Teams — แหล่งข้อมูลคลาสสิกเกี่ยวกับความปลอดภัยทางจิตใจในฐานะเงื่อนไขของการเรียนรู้ของทีม
- NIST Generative AI Profile — confabulation, data privacy, human-AI configuration, overreliance, information integrity และความเสี่ยงอื่นๆ ของ generative AI
- OWASP Top 10 for LLM Applications 2025 — sensitive information disclosure, excessive agency, misinformation และความเสี่ยงเชิงปฏิบัติการของแอปพลิเคชัน LLM
- DORA State of AI-assisted Software Development 2025 — AI ในฐานะตัวขยายจุดแข็งและจุดอ่อนที่มีอยู่ของระบบองค์กร
- EDPB Opinion 28/2024 และ ICO monitoring at work guidance impact assessment — แนวทางเกี่ยวกับข้อมูลส่วนบุคคล ความโปร่งใส ความได้สัดส่วน และขอบเขตของการเฝ้าติดตามในที่ทำงาน