
Sprint Retrospective 與 AI:為什麼改進不能委託給模型
AI 如何改變 Sprint Retrospective:它在哪裡收集流程訊號、為什麼不取代誠實的對話,以及如何不讓回顧變成 AI 建議。
 無法載入此圖片。
這是關於 AI 如何改變跨職能開發團隊經典會議系列的第五篇文章。在前幾部分中,我分析了 Backlog Refinement, Sprint Planning, Daily Scrum 和 Sprint Review. 總體結論正逐漸變得更加嚴格:AI 擅長收集對話的輸入,但不應取代對話本身。在 Sprint Retrospective 中,這條界線尤其重要,因為在這裡團隊討論的不僅是任務和產品,還有自身的習慣、互動、品質和改變的能力。
Sprint Retrospective 看起來是非常適合 AI 的候選對象。衝刺結束時已經有 Jira、Git、pull requests、CI/CD、事故、聊天、日曆、Daily Scrum 的筆記、Sprint Review 的決策,有時還有團隊的簡短調查。模型可以快速彙整:什麼最常阻礙工作、review bottlenecks 卡在哪裡、哪些任務一天天往後拖、Definition of Done 在哪裡變得不清楚、哪些決策反覆出現、哪些主題在過去的回顧中出現過且並未消失。
乍看之下這幾乎是完美的自動化。不需要重新回憶整個衝刺。不需要爭論等待 review 是真實的問題還是只是某人的感覺。不需要手動瀏覽數十個工單和討論分支。AI 可以準備事實、歸納模式、提出 root cause analysis,甚至為下一個衝刺生成 action items。
但正是在這裡,主要的風險開始了。
Sprint Retrospective 的存在不是為了得到一份整齊的改進清單。它的意義在於讓團隊誠實地看見自己如何運作、就應該改變什麼達成共識,並為這個改變承擔責任。如果 AI 把回顧變成一份建議清單,團隊可能得到一份漂亮的文件,卻失去最重要的東西:心理安全感、對問題的共同理解,以及真正的 follow-through。
「AI 可以突顯模式,但改進只有在團隊承認問題並改變自身行為時才開始。」
為什麼需要 Sprint Retrospective
在 Scrum Guide 2020 中,Sprint Retrospective 的描述非常務實:團隊規劃提升品質與效能的方法。為此,Scrum Team 從人員、互動、流程、工具和 Definition of Done 的角度檢視衝刺進行的情況。團隊討論什麼進展順利、出現了什麼問題,以及這些問題是否被解決或未被解決。然後它確定最有用的改變,而最重要的改進應盡快處理,並可納入下一個衝刺的 Sprint Backlog。
也就是說,回顧不是衝刺結束時的情緒宣洩。也不是一場形式上的儀式,只需填寫三欄:什麼好、什麼不好、我們要改進什麼。這個事件關乎工作方式的調適。在這個意義上,它與 Scrum 的整體邏輯直接相關:透明性是為了檢視,檢視是為了調適,而沒有調適的檢視會變得空洞。Scrum Guide 明確強調:Scrum 的事件旨在引發改變,而不只是產出紀錄。
作為額外的參考, Scrum Guide Expanded v2026.1很有用,但僅作為基於 Scrum Guide 2020 的 companion 來源,而不是 Scrum Guide 的新正典版本。對本文而言,它有兩點很重要。第一,它指出反思在心理安全的環境中更有效。第二,在關於 AI 的章節中,它將模型描述為 supervised decision-making partner:AI 可以強化透明性、檢視和調適,但不取代人類的責任,也不取消對流程的實證控制。
因此,我會透過五個功能來描述 Sprint Retrospective 的用途:
- 看見團隊真實的工作模式,而不只是最響亮的意見;
- 在沒有懲罰恐懼的情況下討論互動、流程、工具和 Definition of Done;
- 將事實與詮釋和猜測分開;
- 選擇少量團隊真正準備好嘗試的改進;
- 將這些改進帶入下一個衝刺,使它們有 owner、驗證標準和工作中的位置。
這是討論 AI 的框架。如果工具幫助團隊更好地執行這些功能,它就有用。如果它只是創造一份更漂亮的 action items 清單,它可能很方便,但不一定讓團隊更有效率。
通常會出什麼問題
回顧會議的問題很少在於團隊不會指出問題。通常問題是別的。團隊又再討論同樣的事。行動項目從一個衝刺轉到另一個衝刺。大家說話小心翼翼,因為不想顯得有錯。最痛苦的話題被繞開。Scrum Master 把格式拉出來,卻拉不出改變。最後大家都同意某種像是「我們多溝通一點吧」的說法,而這到下一週就已經消散了。
Lehtinen、Itkonen 和 Lassenius 在 Empirical Software Engineering 上的研究很好地凸顯了回顧會議的這一面。作者們研究了近三年間 37 場團隊層級的回顧會議,並指出了幾件重要的事:討論往往圍繞團隊熟悉且可掌控的主題,但可能受到參與者偏誤的影響;沒有硬證據時,它們不一定反映現實;有些主題長期重複出現,因為它們要麼自然會回來,要麼團隊因其複雜性或缺乏可控性而無法在自己的層級解決。
這對 AI 來說是非常有用的框架。模型確實可以幫助把硬證據帶到以前只有感覺的地方。例如,團隊說:「review 拖慢了衝刺。」AI 可以提出事實:有多少 PR 等了超過一天、哪些具體卡住了、哪些評論重複出現、哪裡在 merge 之後還有返工。這比憑記憶爭論更有用。
但這個框架也有反面。如果團隊不想談論不方便的原因,AI 不會讓它變得更誠實。如果問題在團隊的影響範圍之外,模型可以漂亮地表述一個行動項目,但終究沒有人會執行。如果人們不信任上下文,他們爭論的就不再是流程,而是 AI 是否正確描述了他們的工作。
AI 真正有幫助的地方
在 Sprint Retrospective 中,AI 有一個很強的用處區域,前提是不要試圖把改進本身交給它。我會在回顧之前和回顧之後使用它,而不是用它取代回顧。
但在這裡重要的是不要過度承諾。 DORA State of AI-assisted Software Development 2025 將 AI 描述為組織系統中既有優勢與弱點的放大器。對回顧會議來說,這幾乎是完美的表述:如果團隊已經能夠誠實討論流程並把改進推進到行動,AI 會讓輸入更豐富。如果回顧早已變成一個沒有後續跟進的安全儀式,AI 只會讓這個儀式更快、更整齊。
在會議之前,AI 可以為檢視準備輸入:
- 從 Daily Scrum、ticket、pull request 和 incident note 中收集重複出現的阻礙;
- 找出工作項目長時間等待 review、測試資料、產品負責人決定或外部依賴的地方;
- 比較 Sprint Planning 的計畫、衝刺期間的實際決策,以及 Sprint Review 上討論的結果;
- 凸顯 Definition of Done 與團隊實際關閉任務方式之間的落差;
- 收集舊的行動項目,並顯示哪些已完成、被遺忘或重複出現;
- 擬定供對話使用的候選問題:什麼是事實、什麼是解讀、什麼需要驗證。
在會議之後,AI 可以幫助後續跟進:仔細記錄選定的行動項目,加上 owner、驗證標準、與 Sprint Backlog 的連結,以及對下一次回顧會議的提醒。這特別有價值,因為許多回顧的弱點不在討論,而在於改進活不到下一個衝刺。
但在所有這些情境中,AI 仍然只是準備性與支持性的層次。它不應該決定哪個問題最重要。它不應該指派罪人。它不應該把 root cause 當成事實來判定。它也絕對不應該在沒有實際檢驗的情況下自動寫出「團隊改進計畫」。
為什麼 AI 不應該代替團隊主持回顧會議
AI 輔助回顧會議最危險的版本看起來很成熟。模型收集所有資料、分析團隊情緒、找出「三個主要問題原因」、提出行動項目,並把摘要發到 Slack 或 Confluence。大家讀了、點頭、按了表情符號,回顧就變短了。有時團隊甚至開始想:如果 AI 已經全部分析過了,為什麼還要花一小時對話?
問題在於,回顧會議的價值不只在結論。它的價值在於共同理解的過程。團隊重要的不只是得到「review 花太多時間」這個說法。它需要商定為什麼會這樣、團隊準備改變什麼、接受什麼妥協,以及誰承擔行動。有時在這場對話中會浮現資料上看不到的東西:害怕與強勢開發者爭論、因產品上下文不清而煩躁、對不斷的緊急任務感到疲憊、對當前 Definition of Done 的默默不同意。
Amy Edmondson 的經典研究關於 心理安全感與學習行為 在這裡不是作為時髦的引用,而是作為實務上的指引。如果人們不覺得自己能在沒有人際風險的情況下談論問題,回顧會議就會變成安全的措辭。在這種情況下,AI 可以讓會議記錄更順暢,但無法讓團隊更誠實。
此外,如果團隊把 AI 視為監控,AI 可能反而損害誠實。如果模型讀取 Slack、Jira、PR 評論和行事曆,然後寫出「Alexey 對 review 的反應速度很低」或「QA 經常延遲資料就緒」,這已經不是回顧會議的支援了。這是打著流程改善之名行績效管理之實。在這樣的環境裡,人們會開始優化可見的活動、與模型爭辯、保護自己的名聲,而不是討論真實的流程。
正因如此,像 NIST Generative AI Profile、 OWASP Top 10 for LLM Applications 2025、 EDPB Opinion 28/2024 以及 ICO 關於 monitoring at work 的材料在這裡才相關。不是作為文章的法律章節,而是作為提醒:回顧資料很容易變得敏感。它們涉及人、行為、衝突、錯誤、延遲、往來訊息,有時還涉及管理的弱點。
實務上的界線很簡單:回顧中的 AI 應該分析 work and system, not people。也就是卡住的工作、反覆出現的期待、不清楚的規則、Definition of Done 的缺口、糟糕的 handoffs、流程中過載的節點。不是「誰工作得不好」,而是「系統中的什麼讓我們再次得到同樣的結果」。
「好的回顧 AI-input 著眼於卡住的工作和反覆出現的模式。壞的 AI-input 把人變成報告裡的一行。」
繼續案例:B2B LMS 與 email 提醒
我們沿用前面文章中的同一個案例:B2B LMS 平台、必修課程、對未在截止日前完成必修課程的員工發送 email 提醒。在 Sprint Planning 上,團隊選擇了一個狹窄的 Sprint Goal:系統對有未完成必修課程且尚未到截止日的在職員工發送一則正確的提醒,並保存可驗證的發送歷史。在 Daily Scrum 上,團隊追蹤去重、時區和測試資料的風險。在 Sprint Review 上,團隊討論這對產品和 Product Backlog 意味著什麼。
現在輪到 Sprint Retrospective。沒有 AI 時,對話可能很快落入習慣性的感受。後端說:「我們被 eligibility 的釐清拖住了」。QA 說:「測試資料來得太晚」。前端說:「API 在 sprint 中途變了」。產品負責人說:「我們沒預期到關於 expired會有這麼多問題」。Scrum Master 記下:「改善溝通」、「更早準備資料」、「少改需求」。看起來回顧開過了。
AI 可以讓輸入更具體。它調出 sprint 的歷史並顯示:
- 四個 PR 等待 review 超過一天,而且全都與 retry logic 和 idempotency 有關;
- 對已停用使用者的 eligibility 詮釋改了三次;
- QA data 比團隊在 planning 時預期的晚了三天才出現;
- Definition of Done 沒有要求對負面情境提供可驗證的發送歷史;
- 舊的 action item「縮小 PR 規模」沒有執行,並再次以問題的形式出現;
- Slack 上部分討論不是關於實作,而是關於對
expired缺乏統一的決定。
這是好的輸入。但這還不是回顧會議。
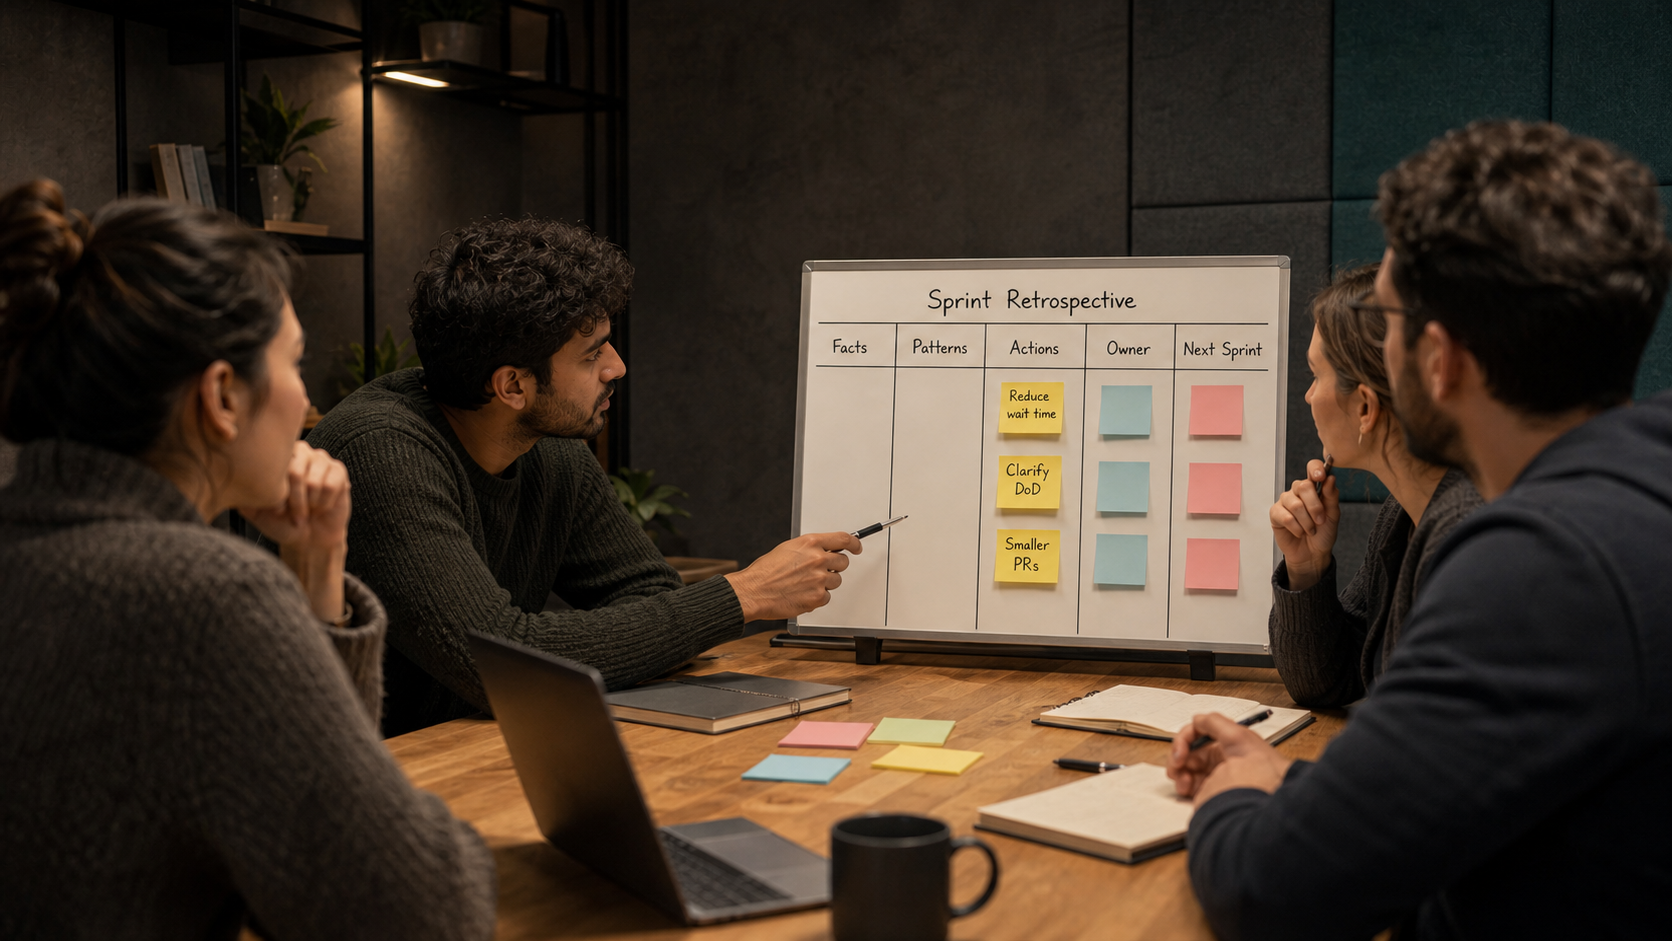
回顧會議始於團隊討論其中哪些真的要改。例如,它可以決定:不是「更早溝通」,而是「在 planning 時明確記錄有爭議的 eligibility 狀態及其 product owner decision」。不是「QA 更快準備資料」,而是「在 Sprint Backlog 中,於關鍵情境開始實作前,為測試資料新增一個獨立的 work item」。不是「少做 PR」,而是「對於 notification architecture 的變更,PR 必須能容納在一個 review 情境中,並在開始工作前就有 review 的 owner」。不是「改善 DoD」,而是「Definition of Done 現在包含對提醒的負面情境提供可驗證的發送歷史」。
這些才是 action items。它們具體、可驗證,並與下一個 sprint 相關。AI 幫助看見了模式。團隊選擇了改變。
反模式
以下是我在將 AI 引入 Sprint Retrospective 時會特別追蹤的幾個反模式。
1. AI 摘要取代了真實對話
如果團隊只是閱讀生成的摘要並表示同意,回顧就失去了最重要的東西。好的問題不是「AI 是否準確描述了這個 sprint?」,而是「其中哪些我們願意改變我們的工作方式?」。
2. 情緒分析變成了關於團隊的真理
語氣分析可能是有用的弱訊號,但它不懂脈絡。諷刺、疲勞、局部衝突、玩笑、沉默和謹慎的措辭都很難轉化為指標。團隊的心情不能化約成一張圖表。
3. AI 尋找罪人而不是系統性模式
一旦模型開始按速度、活躍度或「製造的阻礙數量」對人進行排名,回顧會就變成了監控。這會破壞心理安全感,並降低人們願意提供的資訊品質。
4. 根本原因未經檢驗就被接受
模型可能自信地寫道:「延誤的主要原因是不明確的需求」。但這可能只是可見的部分。真正的原因可能是架構債、優先順序衝突、缺少測試資料,或害怕升級問題。AI 給出的根本原因是假設,而非事實。
5. 行動項目變得過於籠統
「改善溝通」、「加快審查」、「更好地準備」幾乎從不改變行為。好的行動項目應該回答這些問題:誰來做、具體改變什麼、在下一個 Sprint 中哪裡能看到、團隊如何驗證效果。
6. 改進沒有進入 Sprint Backlog
Scrum Guide 允許最重要的改進進入下一個 Sprint 的 Sprint Backlog。如果團隊選了一個改進,卻沒有為它分配注意力、負責人和工作位置,那這不是改進。這是願望。
角色如何變化
AI 不會取消 Scrum Team 內的責任範圍,但會改變對話的準備方式。手動重建 Sprint 歷史的價值降低了。誠實的解讀、選擇一個小實驗,並把改進推進到結果,價值更高了。
| 角色 | 糟糕的 AI 情境下的風險 | 成熟的 AI 使用方式 |
|---|---|---|
| 開發者 | 爭論 AI 對自己活躍度的評估並維護聲譽,而不是討論流程。 | 把事實和模式作為輸入,但自己選擇在工程實踐、審查、DoD 和交接中要改變什麼。 |
| 產品負責人 | 把 AI 回顧當作團隊績效報告來讀,並施壓要求速度。 | 幫助消除產品上的模糊性,釐清阻礙團隊的決策,並支持下一個 Sprint Backlog 中的改進。 |
| Scrum Master | 把引導工作交給模型,得到一份整齊的會議記錄,而不是誠實的對話。 | 使用 AI 輸入做準備,但保護心理安全感、聚焦系統,並確保所選行動項目得到落實。 |
| 品質工程師 / QA 工程師 | 如果模型膚淺地把問題與測試聯繫起來,就會被當成「延誤來源」的角色。 | 幫助把品質訊號轉化為 Definition of Done、測試資料所有權和可觀測性的改變。 |
| UX/UI 設計師 | 從回顧中消失,因為 AI 主要分析程式碼、PR 和開發任務。 | 突顯影響團隊和產品工作品質的互動、決策和使用者情境。 |
| Engineering Lead / Tech Lead | 把 AI 回顧當作控制工程師的儀表板。 | 幫助區分系統性的工程瓶頸與個人活躍度,並選擇真正能放進下一個 Sprint 的技術改進。 |
AI 輔助 Sprint Retrospective 的實用篩選器
我不會從「讓 AI 主持回顧」這個想法開始。我會從一個更窄的問題開始:什麼樣的輸入能幫助團隊更誠實地檢視工作方式,並選擇一兩個它真正會執行的改進?
如果 AI 輸入能幫助回答以下問題,那麼它對 Sprint Retrospective 就是有用的:
- 哪些問題反覆出現,哪些是一次性的;
- 哪些事實支持這個主題,哪些是意見或情緒評價;
- 什麼在團隊的影響範圍內,什麼需要 Supporters、管理層或其他團隊的幫助;
- 哪些舊的行動項目沒有完成,為什麼;
- 下一個 Sprint 中值得改變哪一個流程、工具、工作協議或 Definition of Done;
- 團隊如何驗證改變奏效了。
反過來說:如果 AI 輸入主要回答「誰是瓶頸」,這是一個危險訊號。回顧會應該幫助團隊改進工作系統,而不是產出隱藏的成員排名。
資料與邊界
Sprint Retrospective 對資料特別敏感,因為 AI 很容易開始收集人們視為私人的東西:聊天訊息、回應速度、評論語氣、對 PR 的反應時間、會議參與、重複錯誤、討論中的衝突。存取範圍越廣,分析越有說服力。但敏感情境洩漏、過度依賴模型輸出,以及回顧變成員工監控的風險也越高。
在把 AI 引入回顧之前,我會實際定下幾條規則:
- 使用回答回顧問題所需的最小資料來源集;
- 未經明確約定和必要,不分析私人訊息;
- 不建立個人排名、分數和績效管理結論;
- 向團隊展示使用了哪些資料、排除了哪些資料;
- 把事實與生成的解讀分開;
- 用原始來源核對重要結論;
- 如果 AI 摘要包含敏感的團隊情境,就刪除或限制其儲存。
這不是官僚作風。這是誠實對話的條件。如果人們不明白模型究竟讀取了什麼、其輸出之後又如何被使用,他們就會說得更謹慎。而謹慎的回顧幾乎總是產生安全但微弱的改進。
所以真正改變的是什麼
AI 確實能讓 Sprint Retrospective 更有用。它可以降低準備成本、把事實帶進對話、顯示重複出現的模式、提醒未完成的 action items、標出與 Definition of Done 的落差,並幫助把含糊的「需要改進」轉化為具體的 next-sprint experiment。
但這只有在團隊理解界線時才成立:AI 準備的是供檢視的材料,而不是替團隊進行調適。它幫助看見資料,但不創造心理安全感。它可以提出 root cause,卻不知道人們害怕談論什麼。它可以寫出 action item,但不承擔 owner,也不改變下一個 sprint 的行為。
因此我會把主要論點表述為:AI 應該降低還原事實的成本,讓團隊能把更多注意力留給誠實的對話和選擇一項小幅改進。如果情況相反,Sprint Retrospective 變成自動生成的建議清單,團隊就會失去這個活動存在的確切理由:共同學習、對改變負責,以及提升工作品質的能力。
成熟的團隊不會問:「我們能不能把回顧交給 AI 主持?」它會換個方式問:「AI 能接手哪一部分準備工作,讓我們的回顧更誠實、更具體,也更能落實為行動?」這是個比較不炫目的問題。但正因如此,它更接近真正的 continuous improvement。
來源與參考
- Scrum Guide 2020 — Sprint Retrospective、品質與效能、人員/互動/流程/工具/Definition of Done、最有用的改進,以及與 Sprint Backlog 的連結。
- Scrum Guide Expanded v2026.1 — 以 Scrum Guide 2020 為基礎的 companion 來源:psychological safety、有意義的 continuous improvement follow-through,以及 AI 作為 supervised decision-making partner。
- Scrum.org: Introduction to the Sprint Retrospective — 對 Sprint Retrospective 作為檢視與調適團隊工作實務之活動的實務說明。
- Lehtinen, Itkonen & Lassenius: Recurring opinions or productive improvements — 對近三年 37 場回顧的實證研究:participant bias、hard evidence、recurring topics 與 corrective actions。
- Amy Edmondson: Psychological Safety and Learning Behavior in Work Teams — 關於心理安全感作為 team learning 條件的經典來源。
- NIST Generative AI Profile — confabulation、data privacy、human-AI configuration、overreliance、information integrity 以及生成式 AI 的其他風險。
- OWASP Top 10 for LLM Applications 2025 — sensitive information disclosure、excessive agency、misinformation 以及 LLM 應用程式的營運風險。
- DORA State of AI-assisted Software Development 2025 — AI 作為組織系統既有強項與弱項的放大器。
- EDPB Opinion 28/2024 與 ICO monitoring at work guidance impact assessment — 關於個人資料、透明度、比例原則以及職場監控界線的指引。