
スプリントレトロスペクティブとAI:なぜ改善をモデルに委任できないのか
AIがスプリントレトロスペクティブをどう変えるか:どこでプロセスのシグナルを集めるのか、なぜ正直な対話を置き換えないのか、そしてレトロをAIの推奨事項に変えない方法。
 この画像を読み込めませんでした。
これは、AIがクロスファンクショナルな開発チームの古典的な会議をどう変えるかについてのシリーズ第5回の記事である。前回の記事では以下を分析した: バックログリファインメント, スプリントプランニング, デイリースクラム と スプリントレビュー。全体の結論は徐々に厳しくなっている:AIは対話のための入力収集は得意だが、対話そのものを置き換えるべきではない。スプリントレトロスペクティブではこの境界が特に重要である。なぜならここではチームがタスクやプロダクトだけでなく、自分たちの習慣、相互作用、品質、変化する能力について話し合うからだ。
スプリントレトロスペクティブはAIにとって非常に都合の良い候補に見える。スプリントの終わりにはすでにJira、Git、プルリクエスト、CI/CD、インシデント、チャット、カレンダー、デイリースクラムのメモ、スプリントレビューの決定、時にはチームへの短いアンケートまである。モデルは素早く集められる:何が最も頻繁に作業を妨げたか、どこでレビューのボトルネックが滞留したか、どのタスクが日から日へと持ち越されたか、どこでDefinition of Doneが不明確になったか、どの決定が繰り返されたか、過去のレトロで話題になり消えなかったテーマは何か。
一見するとこれはほぼ完璧な自動化だ。スプリント全体を思い出す必要はない。レビュー待ちが本当の問題だったのか、単に誰かの感覚だったのかを議論する必要もない。何十ものチケットや議論のスレッドを手動で確認する必要もない。AIは事実を準備し、パターンをグループ化し、根本原因分析を提案し、さらには次のスプリントのアクションアイテムを生成することもできる。
しかし、まさにここから最大のリスクが始まる。
スプリントレトロスペクティブは、整った改善リストを得るために存在するのではない。その意味は、チームが自分たちの働き方を正直に見つめ、何を変えるべきかを合意し、その変化に責任を持つことにある。もしAIがレトロを推奨事項のリストに変えてしまうと、チームは美しい文書を得る代わりに最も重要なもの、すなわち心理的安全性、問題への共通理解、実際のフォローアップを失う可能性がある。
「AIはパターンを浮き彫りにできるが、改善はチームが問題を認め、自らの行動を変えたときに初めて始まる。」
スプリントレトロスペクティブが必要な理由
では Scrum Guide 2020 スプリントレトロスペクティブは非常に実践的に説明されている。チームは品質と効率を高める方法を計画する。そのためにスクラムチームは、人々、相互作用、プロセス、ツール、および完成の定義の観点からスプリントがどのように進んだかを検査する。チームは、うまくいったこと、どのような問題が生じたか、そしてそれらの問題がどのように解決されたか、あるいはされなかったかを話し合う。その後、最も有用な変更を特定し、最も重要な改善はできるだけ早く対処されるべきであり、次のスプリントのスプリントバックログに入ることもある。
つまり、レトロスペクティブはスプリント終わりの感情的な息抜きではない。また、良かったこと、悪かったこと、改善することの3つの列を埋める形式的なセレモニーでもない。これは働き方を適応させるためのイベントである。この意味で、それはスクラムの全体的な論理に直接結びついている。透明性は検査のために必要であり、検査は適応のために必要であり、適応のない検査は空虚になる。スクラムガイドは明確に強調している。スクラムのイベントは、単に議事録を生み出すのではなく、変化を促すように設計されている。
追加の指針として有用なのは Scrum Guide Expanded v2026.1しかし、それはScrum Guide 2020に基づくコンパニオンソースとしてであり、Scrum Guideの新しい正典版としてではない。この記事にとって、それが重要なのは二つの点である。第一に、それは心理的に安全な環境の方がreflectionは効果的だと述べている。第二に、AIに関するセクションで、それはこのモデルをsupervised decision-making partnerとして説明している。AIは透明性、検査、適応を強化できるが、人間の責任を代替せず、プロセスの経験的統制を無効にしない。
したがって、私はSprint Retrospectiveの目的を五つの機能を通して説明したい:
- 最も声の大きい意見だけでなく、チームの実際の働き方のパターンを見ること;
- 罰せられる恐れなく、相互作用、プロセス、ツール、Definition of Doneについて話し合うこと;
- 事実を解釈や推測から切り離すこと;
- チームが実際に試す準備ができている少数の改善を選ぶこと;
- これらの改善を次のスプリントに移し、owner、検証基準、作業の中での位置づけを持たせること。
これはAIについて話すための枠組みである。ツールがチームのこれらの機能の遂行を助けるなら、それは有用である。それが単により美しいaction itemsのリストを作るだけなら、便利ではあっても、必ずしもチームをより効果的にするわけではない。
通常うまくいかないこと
レトロスペクティブの問題は、チームが問題を名指しできないことにあることはまれだ。たいてい問題は別のところにある。チームはまた同じことを議論している。アクションアイテムはスプリントからスプリントへと引き継がれていく。人は責任を負っているように見えたくないので、慎重に話す。最も痛みを伴う話題は避けられる。スクラムマスターはフォーマットを引き出すが、変化は引き出せない。最後に全員が「もっとよくコミュニケーションしよう」といったことに同意し、それはすでに次の週には消えている。
Lehtinen、Itkonen、Lasseniusによる研究は Empirical Software Engineering レトロスペクティブのこの側面をよく浮き彫りにしている。著者らはほぼ3年間にわたる37のチームレベルのレトロスペクティブを調査し、いくつかの重要なことを示した:議論はしばしばチームに身近で管理可能な話題に触れるが、participant biasに悩まされることがある;hard evidenceがなければ、現実を常に反映するとは限らない;いくつかの話題は長く繰り返される。それは自然に戻ってくるからか、複雑さや制御不能性のためにチームが自分のレベルで解決できないからだ。
これはAIにとって非常に有用な枠組みだ。モデルは、以前は感覚しかなかった場所にhard evidenceを持ち込むのを確かに助けることができる。例えば、チームが「レビューがスプリントを遅らせている」と言う。AIは事実を提示できる:どれだけのPRが1日以上待ったか、どれが具体的に滞っていたか、どのコメントが繰り返されたか、マージ後の手直しがどこにあったか。これは記憶で議論するより有用だ。
しかし、この同じ枠組みには裏側がある。チームが不快な原因について話したくないなら、AIはそれを正直にはしない。問題がチームの影響範囲の外にあるなら、モデルはアクションアイテムを美しく定式化できるが、それでも誰も実行しないだろう。人々がコンテキストを信頼していないなら、彼らはもはやプロセスについてではなく、AIが自分たちの仕事を正確に描写したかどうかについて議論するだろう。
AIが実際に役立つ場所
Sprint RetrospectiveにおけるAIには、改善そのものを任せようとしない限り、強い有用性の領域がある。私はレトロの前と後にそれを使い、レトロの代わりには使わないだろう。
しかしここでは過剰に約束しないことが重要だ。 DORA State of AI-assisted Software Development 2025 AIを組織システムの既存の強みと弱みの増幅器として描写している。レトロスペクティブにとって、これはほぼ理想的な定式化だ。チームがすでにプロセスを正直に議論し、改善を行動にまで導くことができるなら、AIは入力をより豊かにする。レトロが長い間、フォローアップのない安全な儀式になっているなら、AIはその儀式をより速く、より丁寧にするだけだ。
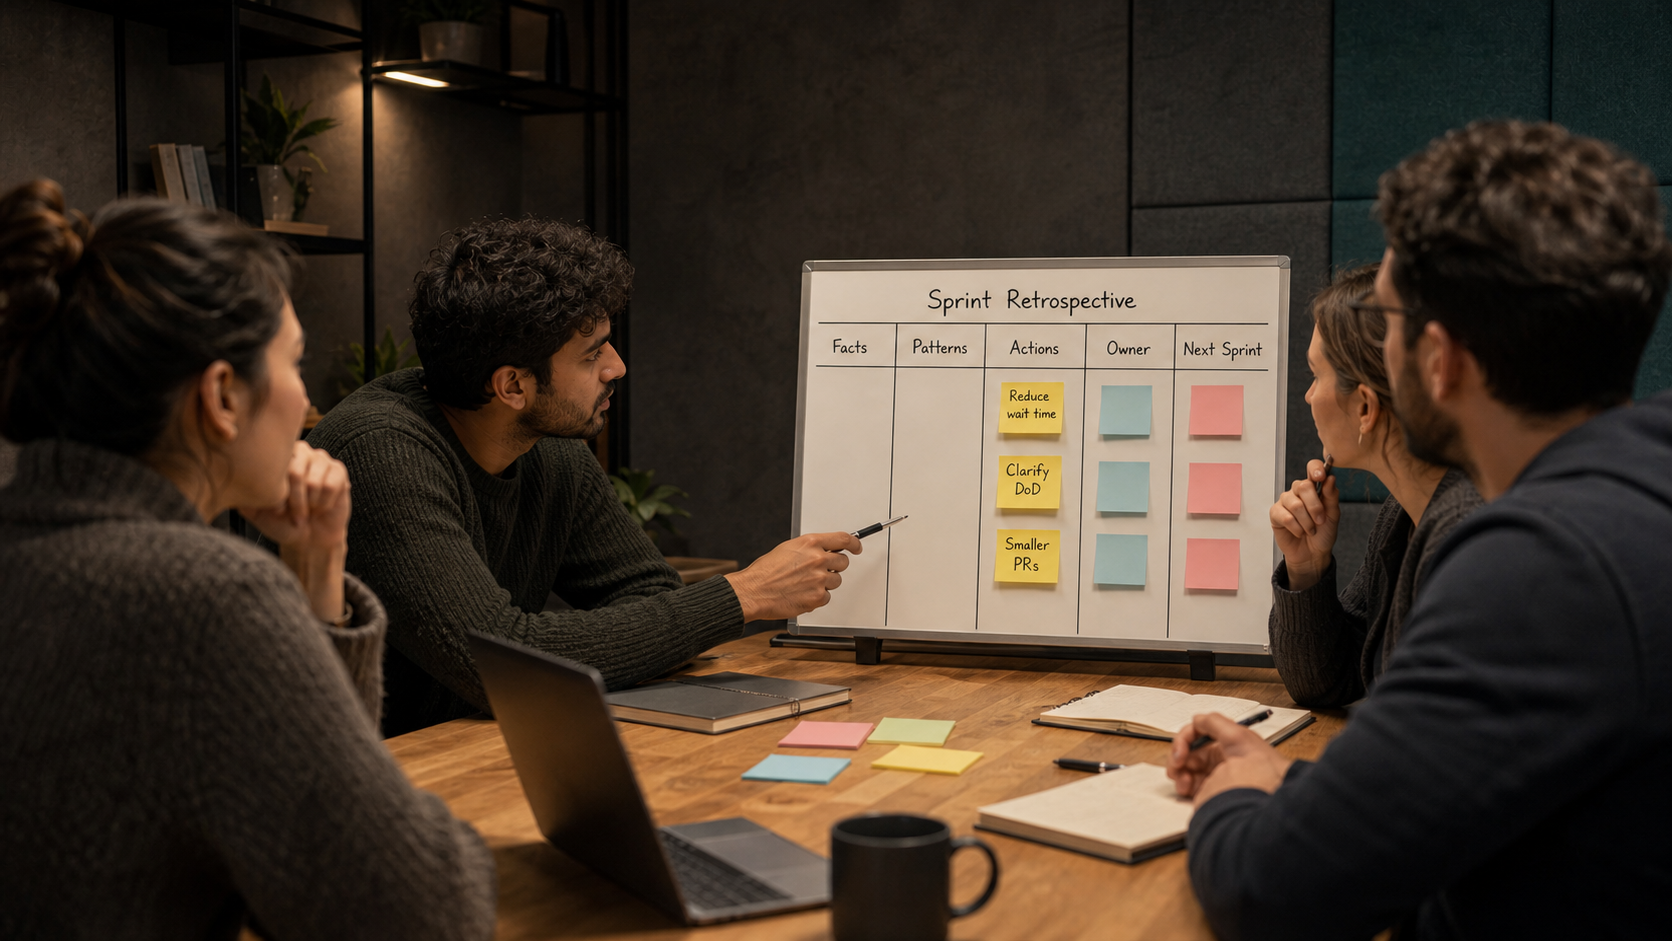
ミーティングの前に、AIは検査のための入力を準備できる:
- Daily Scrum、チケット、pull request、インシデントノートから繰り返し現れるimpedimentsを集める;
- work itemsがレビュー、テストデータ、プロダクトオーナーの決定、または外部依存を長く待っていた箇所を見つける;
- Sprint Planningの計画、スプリント中の実際の決定、そしてSprint Reviewで議論された結果を比較する;
- Definition of Doneと、チームが実際にタスクをクローズした方法との間の不一致を浮き彫りにする;
- 古いアクションアイテムを集め、どれが実行され、忘れられ、または繰り返されたかを示す;
- 会話のための候補となる質問を定式化する:何が事実で、何が解釈で、何が検証を必要としているのか。
ミーティングの後、AIはフォローアップを支援できる:選択されたアクションアイテムを丁寧に記録し、owner、検証基準、Sprint Backlogとの関連、次のレトロスペクティブへのリマインダーを追加する。これは特に価値がある。なぜなら、多くのレトロの弱点は議論ではなく、改善が次のスプリントまで生き残らないことにあるからだ。
しかし、これらすべてのシナリオにおいて、AIは準備的かつ支援的な層にとどまる。どの問題が主要かを決めてはならない。責任者を割り当ててはならない。root causeを事実として断定してはならない。そして、生きた検証なしに「チームの改善計画」を自動的に書くことは決してあってはならない。
なぜAIがチームの代わりにレトロスペクティブを行ってはならないのか
AI支援レトロスペクティブの最も危険なバージョンは成熟して見える。モデルがすべてのデータを集め、チームの雰囲気を分析し、「問題の主な原因3つ」を見つけ、アクションアイテムを提案し、要約をSlackやConfluenceに送る。全員が読み、うなずき、リアクションを付け、レトロは短くなる。時にはチームがそもそも考え始める:AIがすでにすべてを分析したなら、なぜ1時間も会話に費やすのか?
問題は、レトロスペクティブが結論だけでなく、共同理解のプロセスとして価値があることだ。チームにとって重要なのは、「レビューに時間がかかりすぎる」という主張を得ることだけではない。なぜそれが起きているのか、チームが何を変える用意があるのか、どのような妥協を受け入れるのか、誰がアクションを引き受けるのかを合意する必要がある。時にはこの会話の中で、データからは見えないものが浮かび上がる:強い開発者と議論することへの恐れ、不明確なproduct contextによる苛立ち、絶え間ない緊急タスクによる疲労、現在のDefinition of Doneへの静かな不同意。
Amy Edmondsonの古典的な研究は 心理的安全性と学習行動 在这里不是作为时髦的引用,而是作为实践性的指南。如果人们不觉得自己可以在没有人际风险的情况下谈论问题,回顾就会变成安全的措辞。在这种情况下,AI 可以让会议记录更顺畅,但无法让团队更诚实。
此外,如果团队将其视为监控,AI 可能会损害诚实性。如果模型读取 Slack、Jira、PR 评论和日历,然后写道“Alexey 对 review 的反应速度低”或“QA 经常延迟数据的就绪”,这已经不是对回顾的支持。这是以流程改进为名的绩效管理。在这种环境中,人们开始优化可见的活动,与模型争论并保护声誉,而不是讨论真实的流程。
正因如此,像 NIST 生成式 AI 概况, OWASP 2025 年 LLM 应用十大风险, EDPB 第 28/2024 号意见 以及 ICO 关于 工作中的监控 在这里是相关的。不是作为文章的法律章节,而是作为提醒:回顾性数据很容易变得敏感。它们涉及人、行为、冲突、错误、延迟、通信,有时还涉及管理的薄弱环节。
实践边界很简单:回顾中的 AI 应该分析工作和系统,而不是人。也就是说,卡住的工作、重复的期望、不清晰的规则、完成定义中的空白、糟糕的交接、流程中的过载点。不是“谁工作得不好”,而是“系统中是什么让我们再次得到同样的结果”。
“好的回顾 AI 输入关注卡住的工作和重复的模式。糟糕的回顾 AI 输入把人变成报告中的行。”
继续案例:B2B LMS 和电子邮件提醒
让我们沿用之前文章中的同一个案例:B2B LMS 平台、必修课程、向未在截止日期前完成必修课程的员工发送电子邮件提醒。在 Sprint Planning 上,团队选择了一个狭窄的 Sprint Goal:系统向有未完成必修课程的活跃员工发送一条正确的提醒,并保存可验证的发送历史。在 Daily Scrum 上,团队跟踪了去重、时区和测试数据的风险。在 Sprint Review 上,团队讨论了这对产品和 Product Backlog 意味着什么。
现在到了 Sprint Retrospective。没有 AI,对话可能很快陷入习惯性的感受。后端说:“我们被 eligibility 的澄清拖住了”。QA 说:“测试数据来得太晚”。前端说:“API 在 sprint 中途变了”。产品负责人说:“我们没预料到关于 expired会有这么多问题”。Scrum Master 记录:“改善沟通”、“提前准备数据”、“少改需求”。回顾似乎开过了。
AI 可以让输入更具体。它调出 sprint 的历史并显示:
- 四个 PR 等待 review 超过一天,且都与 retry logic 和 idempotency 有关;
- 对已停用用户的 eligibility 解释改变了三次;
- QA 数据比团队在 planning 时预期的晚了三天出现;
- 完成定义不要求对负面场景提供可验证的发送历史;
- 旧的 action item“减小 PR 大小”没有完成,并作为问题再次出现;
- Slack 中的部分讨论不是关于实现,而是关于缺乏对
expired.
的统一决策。
这是一个好的输入。但这还不是回顾。
回顾始于团队讨论其中哪些真正需要改变。例如,它可以决定:不是“更早沟通”,而是“在 planning 时明确记录有争议的 eligibility 状态及其产品负责人的决策”。不是“QA 更快准备数据”,而是“在 Sprint Backlog 中,在开始实现关键场景之前,为测试数据添加单独的工作项”。不是“少做 PR”,而是“对于通知架构的更改,PR 必须能容纳在一个 review 场景中,并在工作开始前有 review 负责人”。不是“改进 DoD”,而是“完成定义现在包括对提醒负面场景的可验证发送历史”。
反模式
以下是几个我在将 AI 引入 Sprint Retrospective 时会特别跟踪的反模式。
1. AI 摘要取代了实时对话
如果团队只是阅读生成的摘要并同意它,回顾就失去了最重要的东西。好的问题不是“AI 是否准确描述了 sprint?”,而是“我们准备在工作中改变其中的什么?”。
2. 情感分析变成了关于团队的真相
情感分析可能是有用的弱信号,但它不了解上下文。讽刺、疲劳、局部冲突、玩笑、沉默和谨慎的措辞很难转化为指标。团队的情绪不能简化为图表。
3. AI 寻找责任人而不是系统模式
モデルが人々を速度、活動量、「作成したブロッカーの数」でランク付けし始めた瞬間、レトロスペクティブはモニタリングに変わる。これは心理的安全性を壊し、人々が進んで持ち出す情報の質を悪化させる。
4. 根本原因が検証なしに受け入れられる
モデルは「遅延の主な原因は不明確な要件だ」と自信を持って書くかもしれない。しかしそれは見えている部分にすぎないかもしれない。実際の原因はアーキテクチャの負債、優先順位の衝突、テストデータの不足、あるいは問題をエスカレーションすることへの恐れかもしれない。AIの根本原因は仮説であり、事実ではない。
5. アクションアイテムが一般的すぎる
「コミュニケーションを改善する」「レビューを速くする」「もっと準備する」はほとんど行動を変えない。良いアクションアイテムは次の問いに答えるべきだ:誰がやるのか、具体的に何を変えるのか、次のスプリントのどこでそれが見えるのか、チームが効果をどう確認するのか。
6. 改善がSprint Backlogに入らない
Scrum Guideは最も重要な改善が次のスプリントのSprint Backlogに入ることを認めている。チームが改善を選んだのに、それに注意、オーナー、仕事の中での場所を割り当てなかったなら、それは改善ではない。それは願望だ。
役割はどう変わるか
AIはスクラムチーム内の責任範囲をなくさないが、対話への準備を変える。スプリントの歴史を手作業で復元する価値は減る。正直な解釈、小さな実験の選択、改善を結果まで導くことに、より大きな価値がある。
| 役割 | AIシナリオが不十分な場合のリスク | 成熟したAIの活用 |
|---|---|---|
| 開発者 | AIによる自分の活動評価に反論し、プロセスを議論する代わりに評判を守ろうとする。 | 事実とパターンを入力として使うが、エンジニアリングプラクティス、レビュー、DoD、ハンドオフの何を変えるかは自分たちで選ぶ。 |
| プロダクトオーナー | AIレトロをチームのパフォーマンス報告書として読み、速度を押し付ける。 | プロダクトの曖昧さを取り除き、チームを妨げていた決定を明確にし、次のSprint Backlogでの改善を支援する。 |
| スクラムマスター | ファシリテーションをモデルに任せ、正直な対話の代わりに整った議事録を受け取る。 | 準備のためにAIの入力を活用するが、心理的安全性、システムへのフォーカス、選択したアクションアイテムのフォローアップを守る。 |
| 品質エンジニア / QAエンジニア | モデルが問題を表面的にテストと結びつけると、「遅延の源」という役割を負わされる。 | 品質のシグナルをDefinition of Doneの変更、テストデータのオーナーシップ、可観測性へと変換するのを支援する。 |
| UX/UIデザイナー | AIが主にコード、PR、開発タスクを分析するため、レトロから外れてしまう。 | チームとプロダクトの仕事の質に影響した相互作用、決定、ユーザーコンテキストを浮き彫りにする。 |
| エンジニアリングリード / テックリード | AIレトロをエンジニアを管理するためのダッシュボードとして使う。 | システム的なエンジニアリングのボトルネックと個人の活動を区別し、次のスプリントに実際に収まる技術的改善を選ぶのを支援する。 |
AI支援レトロスペクティブのための実践的フィルター
私は「AIにレトロをやらせよう」というアイデアから始めないだろう。もっと狭い問いから始める。すなわち、どの入力がチームの働き方をより正直に検査し、チームが実際に実行する1〜2の改善を選ぶのに役立つのか、という問いだ。
Sprint RetrospectiveへのAI入力は、次の問いに答えるのに役立つなら有用だ:
- どの問題が繰り返し起き、どれが一度きりだったか;
- どの事実がテーマを裏付け、どれが意見や感情的な評価か;
- 何がチームの影響範囲にあり、何がサポーターズ、マネジメント、他のチームの助けを必要とするか;
- どの古いアクションアイテムが実行されず、その理由は何か;
- 次のスプリントで変える価値のあるプロセス、ツール、ワーキングアグリーメント、Definition of Doneはどれか;
- チームがその変更が効いたことをどう確認するか。
逆に、AI入力が主に「誰がボトルネックだったか」という問いに答えるなら、それは危険なシグナルだ。レトロスペクティブはチームが働き方のシステムを改善するのを助けるべきであり、参加者の隠れたランキングを生み出すべきではない。
データと境界
Sprint Retrospectiveはデータに特に敏感だ。なぜならAIは人々が個人的だと受け取るものを簡単に集め始めるからだ:チャットのメッセージ、応答速度、コメントのトーン、PRへの反応時間、会議への参加、繰り返されるミス、議論での衝突。アクセスが広いほど分析は説得力を持つ。しかし機密性の高いコンテキストの漏洩、モデルの出力への過度な依存、レトロが従業員モニタリングに変わるリスクは高まる。
実際には、AIをレトロに導入する前にいくつかのルールを定めるだろう:
- レトロの問いに必要な最小限の情報源を使う;
- 明示的な合意と必要性なしに個人メッセージを分析しない;
- 個人のランキング、スコア、パフォーマンスマネジメントに関する結論を作らない;
- どのデータが使われ、どれが除外されたかをチームに示す;
- 事実と生成された解釈を分ける;
- 重要な結論は一次情報で確認する;
- AIの要約が機密性の高いチームコンテキストを含む場合は、削除するか保存を制限する。
これは官僚主義ではない。正直な対話のための条件だ。人々がモデルが何を読んでいるのか、その出力がその後どう使われるのかを理解していなければ、より慎重に話すようになる。そして慎重な振り返りは、ほぼ常に安全だが弱い改善しか生み出さない。
では実際に何が変わるのか
AIは実際にSprint Retrospectiveをより有益なものにできる。準備のコストを下げ、対話に事実を持ち込み、繰り返されるパターンを示し、未完了のaction itemを思い出させ、Definition of Doneとの乖離を浮き彫りにし、漠然とした「改善すべき」を具体的なnext-sprint experimentへと変える手助けができる。
しかしこれは、チームがその境界を理解している場合にのみ機能する。AIはinspectionのための材料を準備するのであって、チームの代わりにadaptationを行うのではない。データを見えるようにするが、心理的安全性を生み出すわけではない。root causeを提案することはできるが、人々が何について話すのを恐れているかは知らない。action itemを書くことはできるが、ownerを引き受けず、次のスプリントで行動を変えることもない。
だからこそ、主要な命題はこう定式化したい:AIは事実を復元するコストを下げ、チームが正直な対話と小さな改善の選択により多くの注意を残せるようにすべきだ。逆のことが起き、Sprint Retrospectiveが自動生成された推奨事項のリストに変わってしまえば、チームはこのイベントが存在するまさにその理由を失う:共同での学習、変化への責任、そして仕事の質を高める能力である。
成熟したチームは「AIにレトロスペクティブを任せられるか?」とは問わない。そうではなくこう問う:「AIが準備のどの部分を引き受けられるか、それによって私たちのレトロスペクティブがより正直に、より具体的になり、よりよく行動につながるか?」これは派手さのない問いだ。だがまさにこれこそが実際のcontinuous improvementに近い。
出典と指針
- Scrum Guide 2020 — Sprint Retrospective、品質と効果性、人/相互作用/プロセス/ツール/Definition of Done、最も有用な改善、そしてSprint Backlogとの関連。
- Scrum Guide Expanded v2026.1 — Scrum Guide 2020をベースにしたコンパニオン資料:心理的安全性、意味のある継続的改善の実行、そしてAIを監督された意思決定パートナーとして位置づけること。
- Scrum.org: Introduction to the Sprint Retrospective — チームの作業プラクティスのinspection and adaptationのためのイベントとしてのSprint Retrospectiveを実践的に解説したもの。
- Lehtinen, Itkonen & Lassenius: Recurring opinions or productive improvements — ほぼ3年間にわたる37回のレトロスペクティブの実証研究:participant bias、hard evidence、繰り返されるトピック、是正措置。
- Amy Edmondson: Psychological Safety and Learning Behavior in Work Teams — チーム学習の条件としての心理的安全性に関する古典的文献。
- NIST Generative AI Profile — confabulation、データプライバシー、human-AI configuration、overreliance、情報の完全性など、生成AIのその他のリスク。
- OWASP Top 10 for LLM Applications 2025 — 機密情報の開示、excessive agency、誤情報、およびLLMアプリケーションの運用リスク。
- DORA State of AI-assisted Software Development 2025 — 組織システムに既存する強みと弱みの増幅器としてのAI。
- EDPB Opinion 28/2024 および ICO monitoring at work guidance impact assessment — 個人データ、透明性、比例性、職場モニタリングの限界に関する指針。