
Thực tiễn sử dụng xếp hạng cá nhân của từng thành viên nhóm trong bối cảnh Scrum và SAFe
Trong bài viết này, tôi dự định kể về cách trong thực tiễn của mình, chúng tôi tính toán và áp dụng xếp hạng cá nhân của từng thành viên nhóm trong Scrum trong quá trình làm việc theo khung SAFeBlog cá nhân.
 Không thể tải ảnh này.
Trong bài viết này, tôi dự định kể về cách trong thực tiễn của mình chúng tôi áp dụng Xếp hạng cá nhân của từng thành viên nhóm trong Scrum trong quá trình làm việc theo khung SAFe
Có lẽ nhiều người sẽ đồng ý rằng (đặc biệt là ở Nga) mọi người khá thường xuyên cố gắng làm việc (cung cấp sản phẩm cuối cùng trong phạm vi năng lực của mình hoặc thông qua việc tiếp thu năng lực mới) ít hơn và nhận được nhiều tiền hơn. Với quy mô công ty, cơ hội cho điều này dường như tăng lên theo tỷ lệ thuận. Với điều này, theo quy luật, các bộ phận HR khác nhau làm việc, những người bằng mọi cách cố gắng xây dựng một hệ thống động lực đúng đắn. Ở đây cũng có OKR và v.v. Nhìn chung, có vẻ như tất cả những điều này đều nhằm mục đích cân bằng tải trọng của từng người bên trong tập đoàn và sự thoải mái của tất cả các nhóm/bên liên quan của tập đoàn. Trong bài viết này, tôi sẽ chia sẻ một chỉ số mà tôi tự nghĩ ra và áp dụng trong nhóm. Theo tôi, nó cho phép bổ sung nỗ lực của HR và OKR trong việc cân bằng tải trọng bên trong một nhóm cụ thể hoặc theo đó nhìn thấy sự mất cân bằng. Ngoài ra, nó hoàn toàn có thể mở rộng cho nhóm của các nhóm, tôi không thấy có vấn đề đặc biệt gì ở đây.
Vì vậy, với tư cách là Scrum Master, đôi khi tôi thấy khá rõ ràng rằng tải trọng trong nhóm không được cân bằng, có người làm việc cho hai người, có người không làm gì cả (đây là những dạng cực đoan và, tất nhiên, là một vấn đề nghiêm trọng, nhưng chỉ số này cũng cho thấy không chỉ những dạng cực đoan). Tình huống như vậy đã xảy ra với tôi và tôi đã suy nghĩ về việc chỉ số nào có thể làm nổi bật rõ ràng vấn đề này. Kết quả là, nó đã dẫn đến xếp hạng cá nhân của từng thành viên nhóm.
Trước khi mô tả bản thân chỉ số, tôi muốn cũng nêu ra một ý tưởng rất quan trọng, theo tôi. Hiện tại tôi hoàn toàn chắc chắn về nó.
Các chỉ số phải được xây dựng trên cơ sở những dữ liệu mà bạn vốn đã nhận được. Việc thu thập bất kỳ chỉ số nào không nên buộc nhóm phải thường xuyên dành nhiều thời gian hơn và điều chỉnh quy trình cung cấp giá trị của mình theo chính chỉ số đó. Tôi sẽ cố gắng kể chi tiết hơn về điều này trong một trong những bài viết tiếp theo.
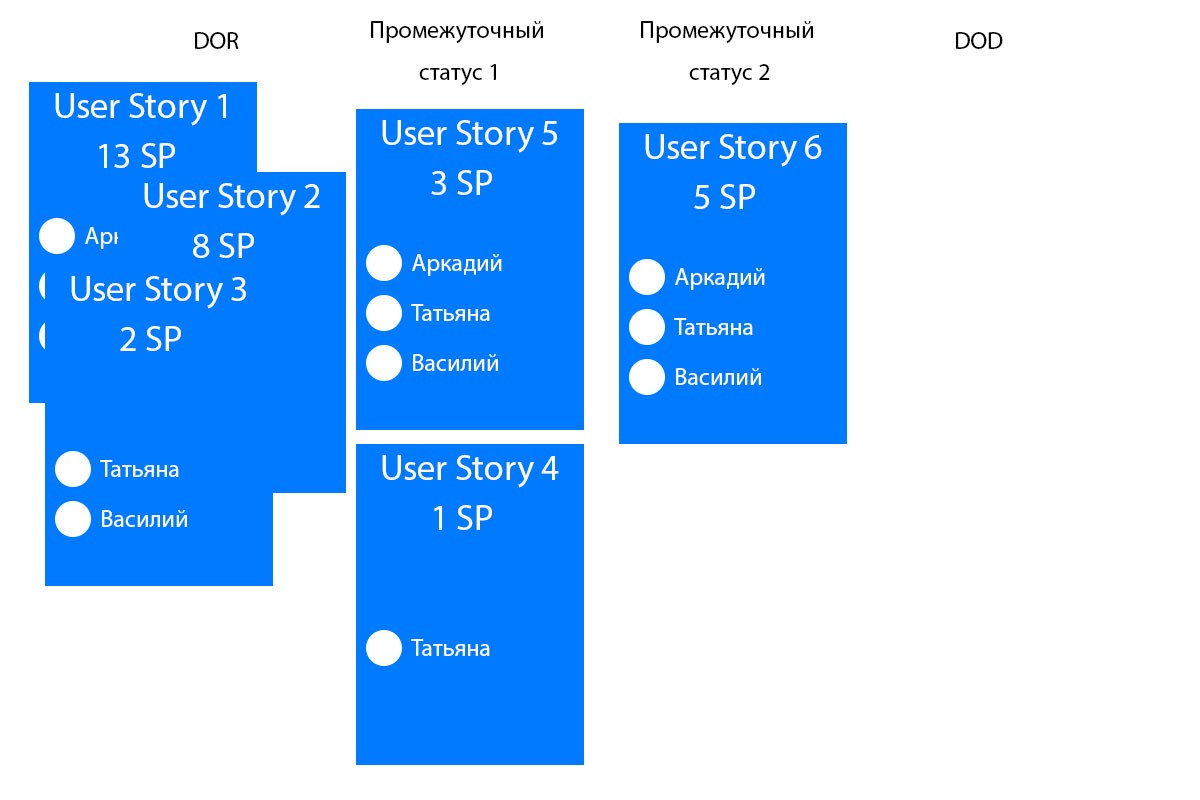
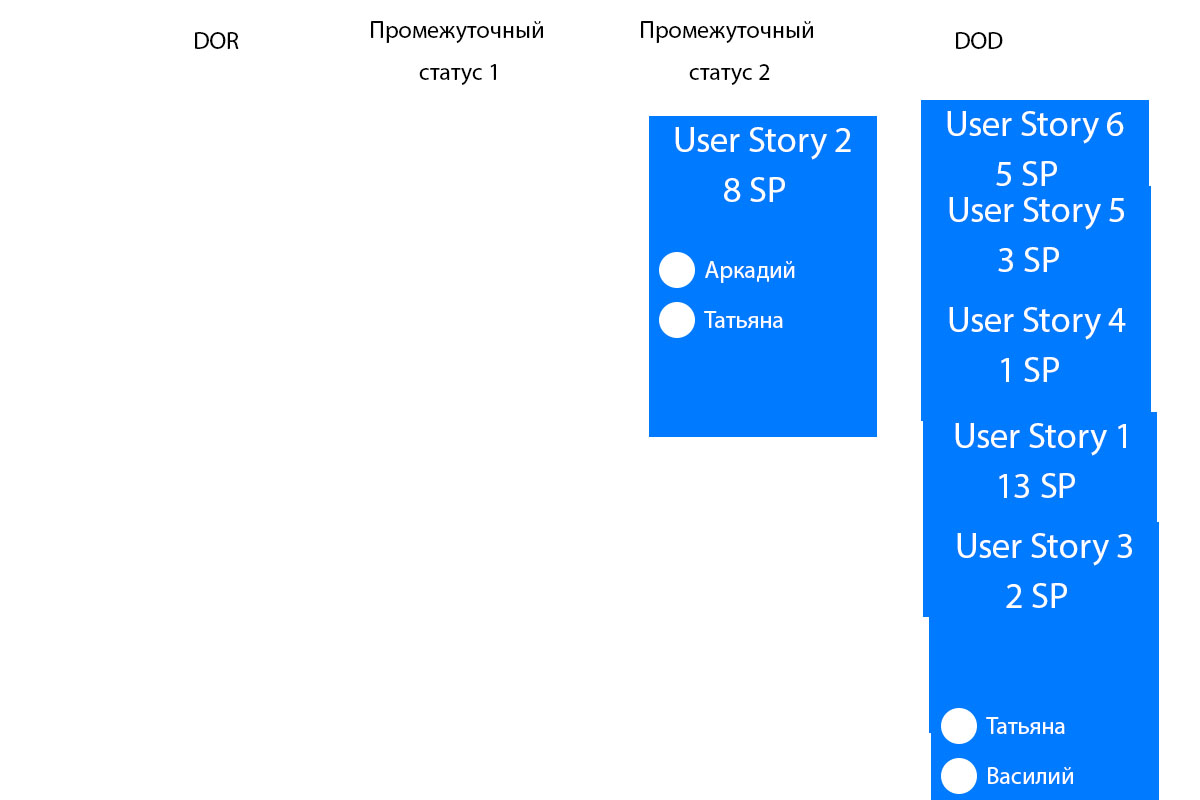
Vậy, ví dụ về một trường hợp cụ thể. Tất nhiên, chúng tôi sử dụng bảng để di chuyển User Stories theo các trạng thái từ DOR (Definition Of Ready) đến DOD (Definition Of Done). Bảng của chúng tôi là ảo (tức là nằm trên internet qua liên kết. Nhóm của chúng tôi cũng là nhóm phân tán và các buổi standup diễn ra qua Skype của công ty cùng với việc truyền phát bảng.
Thành viên nhóm thuận tiện khi đặt mình vào những người tham gia User Story, để khi sử dụng bộ lọc theo bản thân có thể nhanh chóng chỉ để lại những câu chuyện mà anh ta tham gia vào thời điểm hiện tại (thường nhất chúng tôi sử dụng bộ lọc này trong các buổi standup).
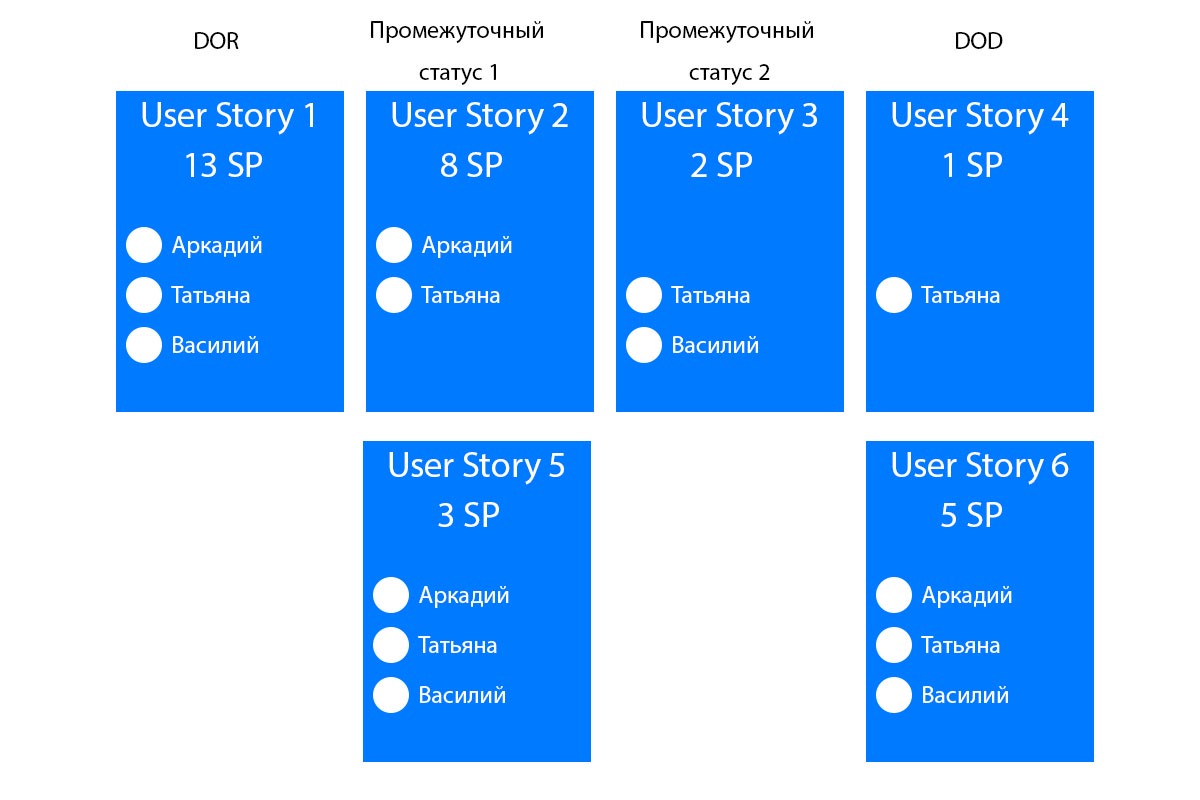
Ở đây cũng muốn đưa ra giải thích: điều này không có nghĩa là thành viên nhóm này không thể tham gia vào các câu chuyện khác (nếu, ví dụ, trong buổi standup ai đó trong nhóm yêu cầu giúp đỡ, anh ta hoàn toàn có thể trở thành người tham gia câu chuyện mới hoặc ngược lại, nếu cảm thấy rằng sự tham gia của mình không cần thiết, có thể ngừng là người tham gia của bất kỳ câu chuyện nào.
Vì vậy, để tính xếp hạng của từng thành viên nhóm, chúng ta cần xem mỗi thành viên nhóm ảnh hưởng đến bao nhiêu SP. Trong trường hợp của chúng tôi, Arkady ảnh hưởng đến 29 SP (câu chuyện 1, 2, 5, 6), Tatyana ảnh hưởng đến 33 SP (tham gia vào tất cả các câu chuyện), Vasily ảnh hưởng đến 23 SP (câu chuyện 1, 3, 5, 6).
Đã đóng (hoàn thành DOD) ở Arkady là 5 trong 29 SP, ở Tatyana là 6 trong 32 SP, ở Vasily là 5 trong 23. Tôi đã
khá lâu vật lộn với việc sắp xếp và đã đi đến công thức so sánh hai thành viên
nhóm như sau (team[i] - một thành viên nhóm và team[j] - thành viên nhóm khác):
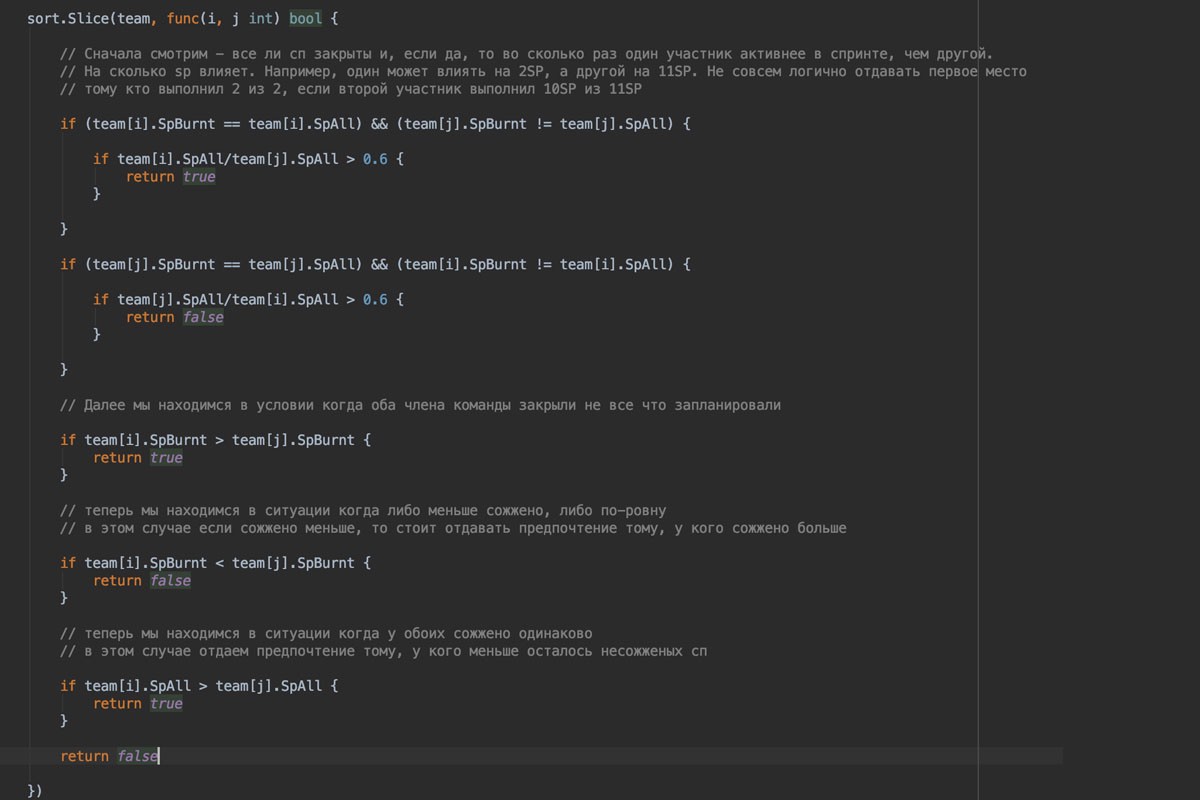
Theo cách sắp xếp này, chúng ta sẽ nhận được xếp hạng hiện tại của các thành viên nhóm như sau.
- Vị trí 1. Vasily (Hoàn thành 5 trong 23)
- Vị trí 2. Arkady (Hoàn thành 5 trong 29)
- Vị trí 3. Tatyana (Hoàn thành 6 trong 32)
Bây giờ hãy tạo tất cả dữ liệu theo sprint. Hãy tưởng tượng rằng sprint kéo dài 5 ngày làm việc.
- Ngày 1
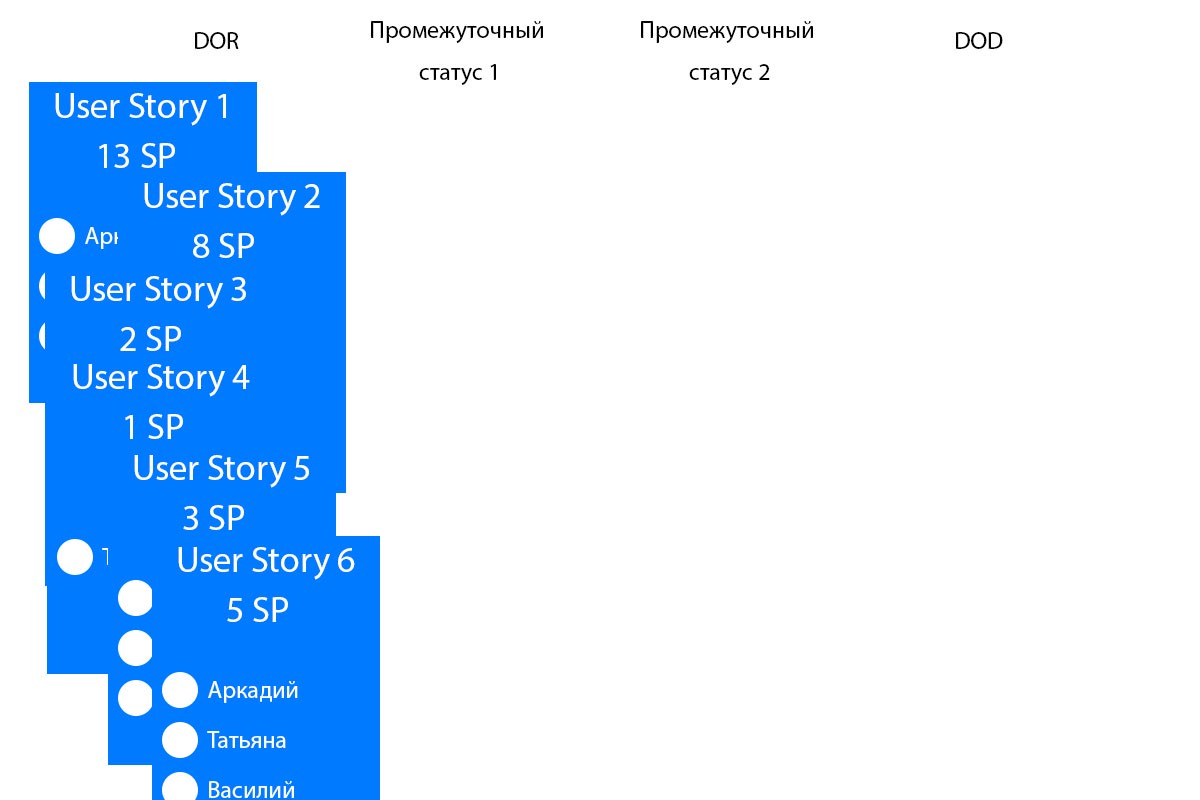
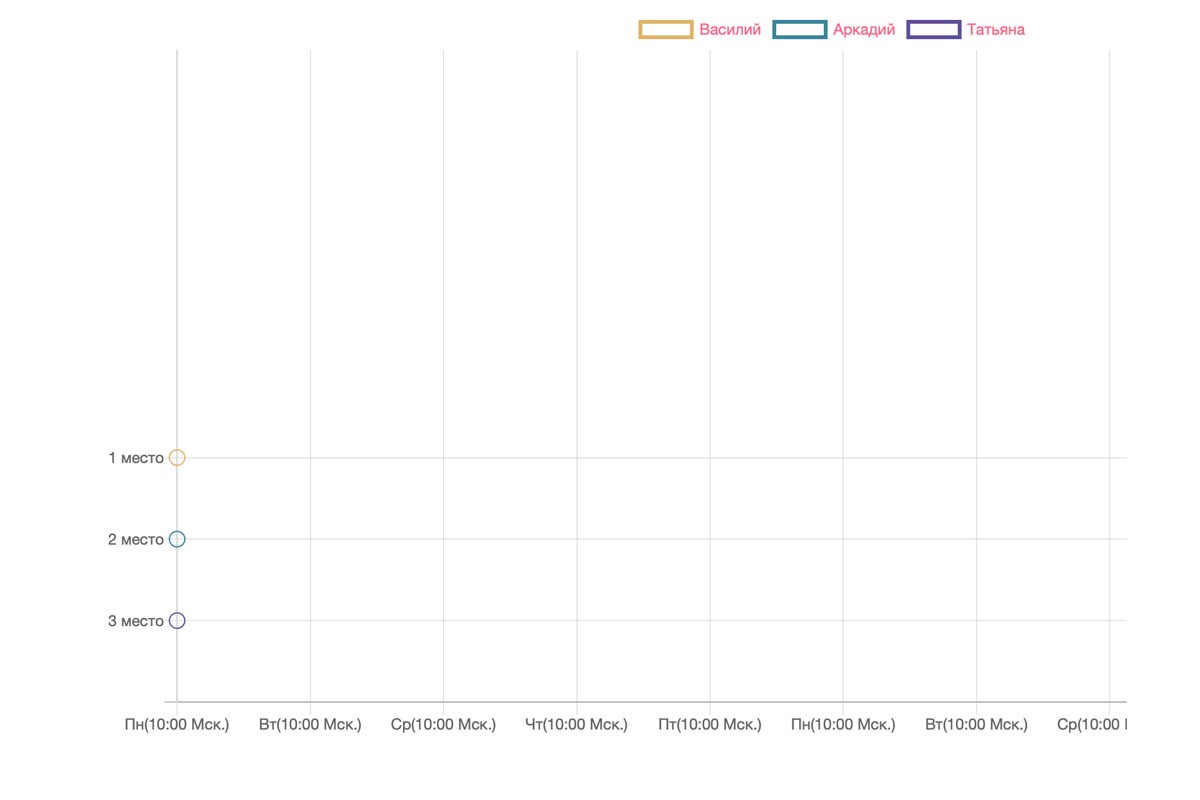
Vị trí 1: Vasily (đã đốt 0 trong 23)
Vị trí 2: Arkady (đã đốt 0 trong 29)
Vị trí 3: Tatyana (đã đốt 0 trong 32) - Ngày 2
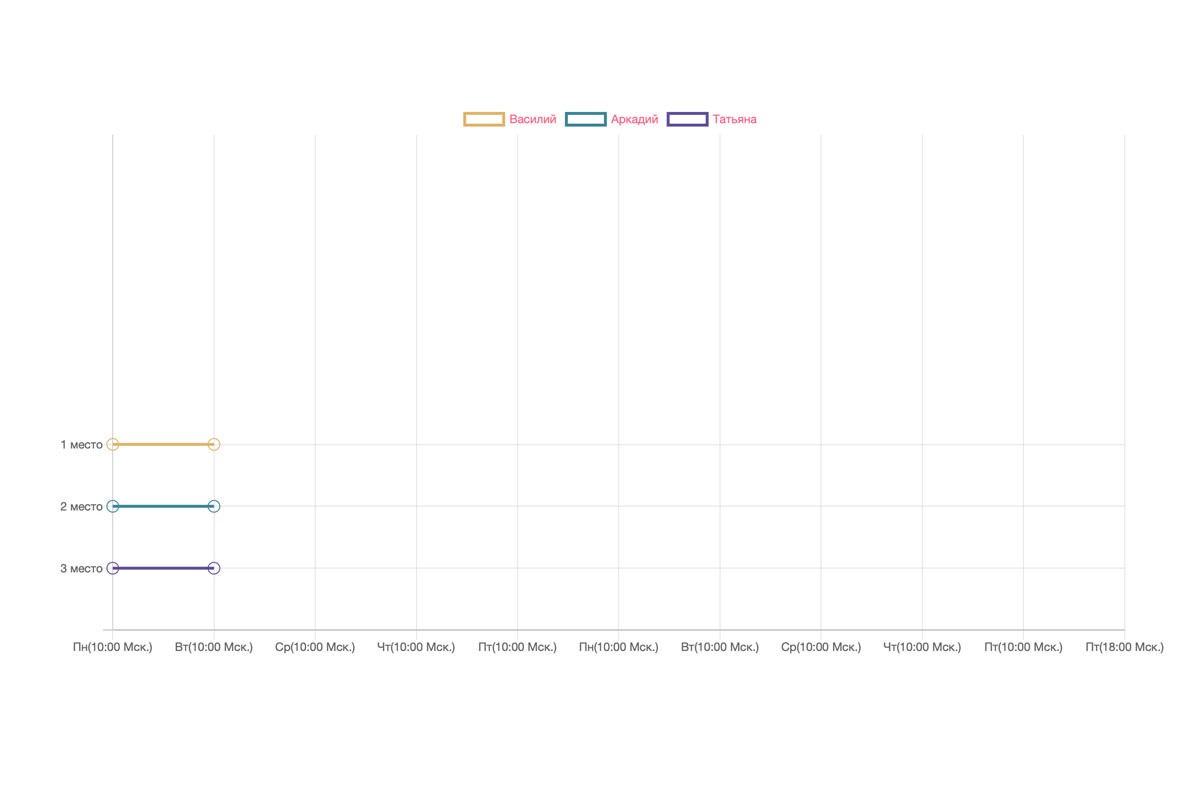
Vị trí 1: Vasily (đã đốt 0 trong 23) động thái(1->1)
Vị trí 2: Arkady (đã đốt 0 trong 29) động thái(2->2)
Vị trí 3: Tatyana (đã đốt 0 trong 32) động thái(3->3) - Ngày 3
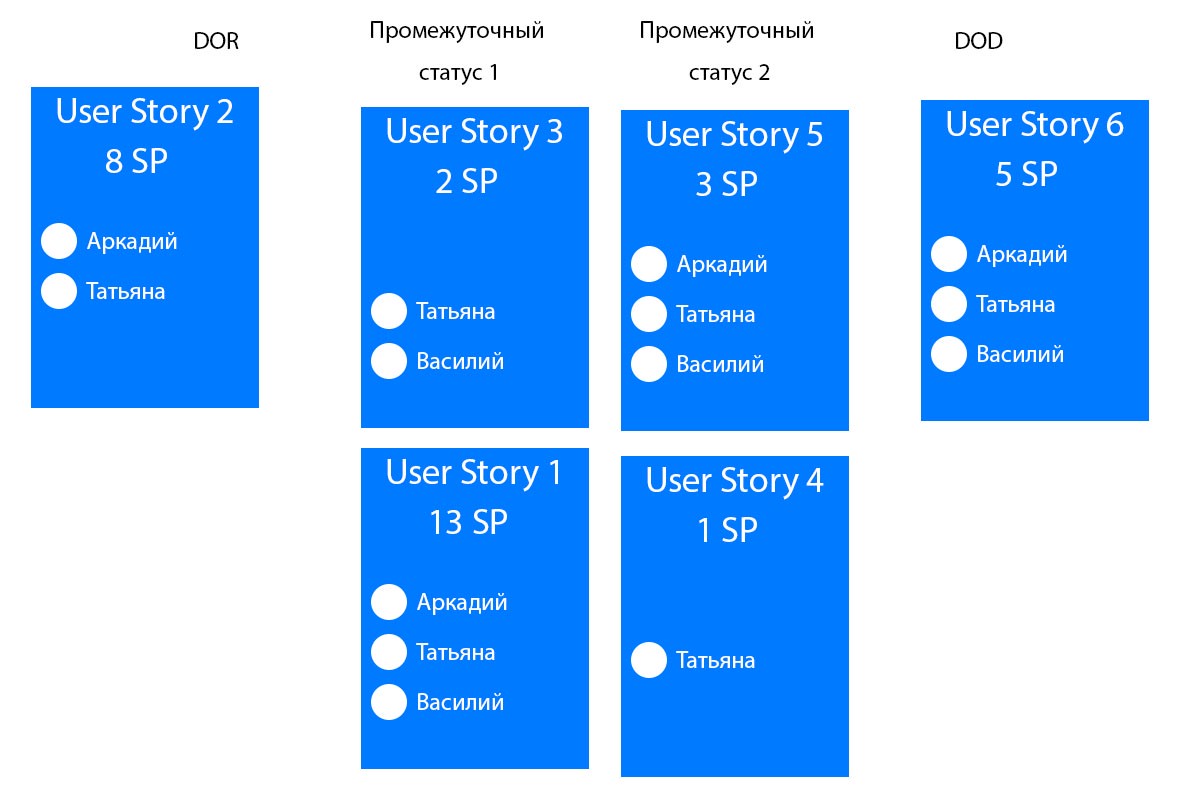
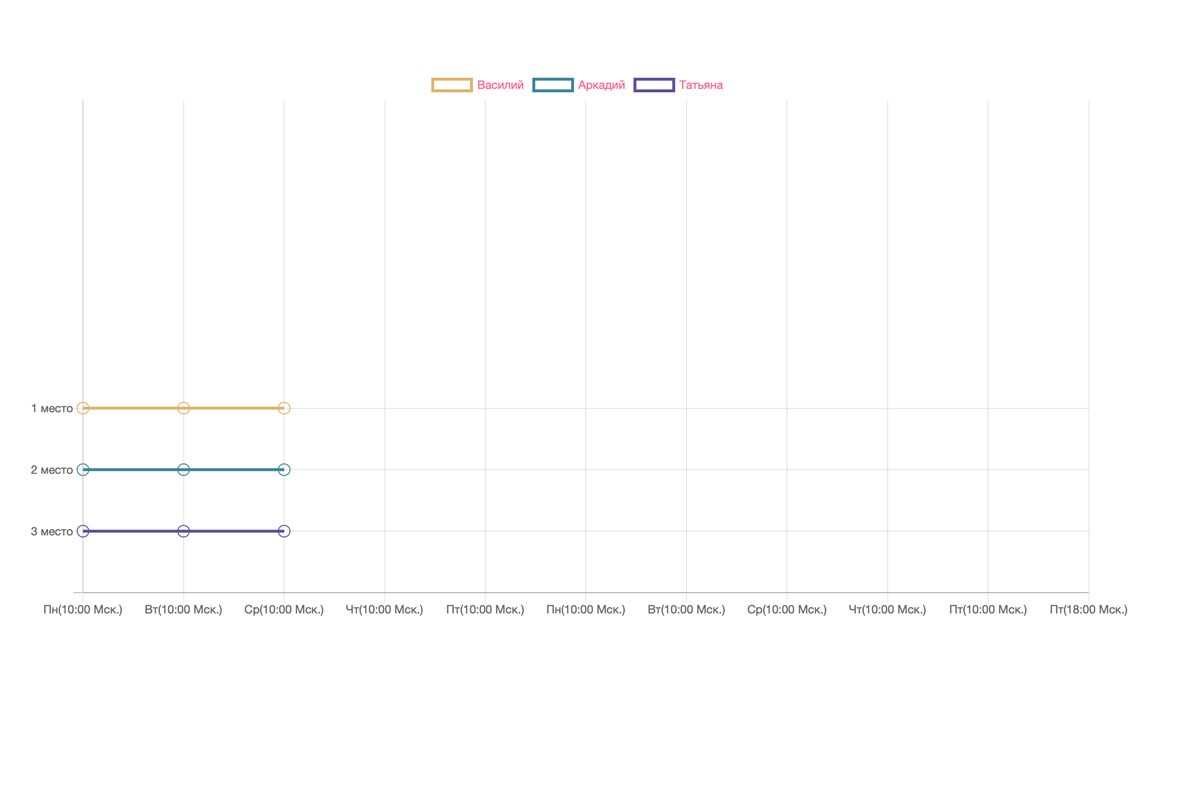
Vị trí 1: Vasily (đã đốt 5 trên 23) động thái(1->1->1)
Vị trí 2: Arkady (đã đốt 5 trên 29) động thái(2->2->2)
Vị trí 3: Tatyana (đã đốt 5 trên 32) động thái(3->3->3) - Ngày 4

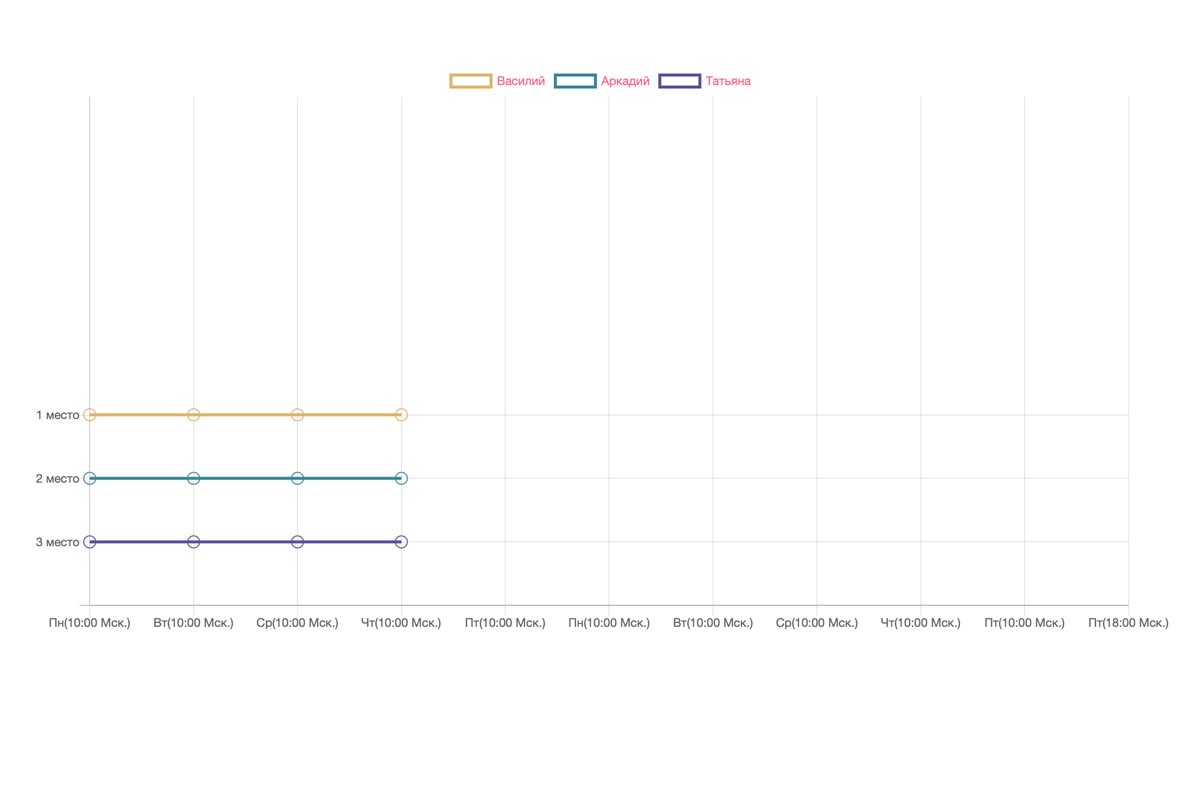
Vị trí 1: Vasily (đã đốt 8 trên 23) động thái(1->1->1->1)
Vị trí 2: Arkady (đã đốt 8 trên 29) động thái(2->2->2->2)
Vị trí 3: Tatyana (đã đốt 9 trên 32) động thái(3->3->3->3) - Ngày 5
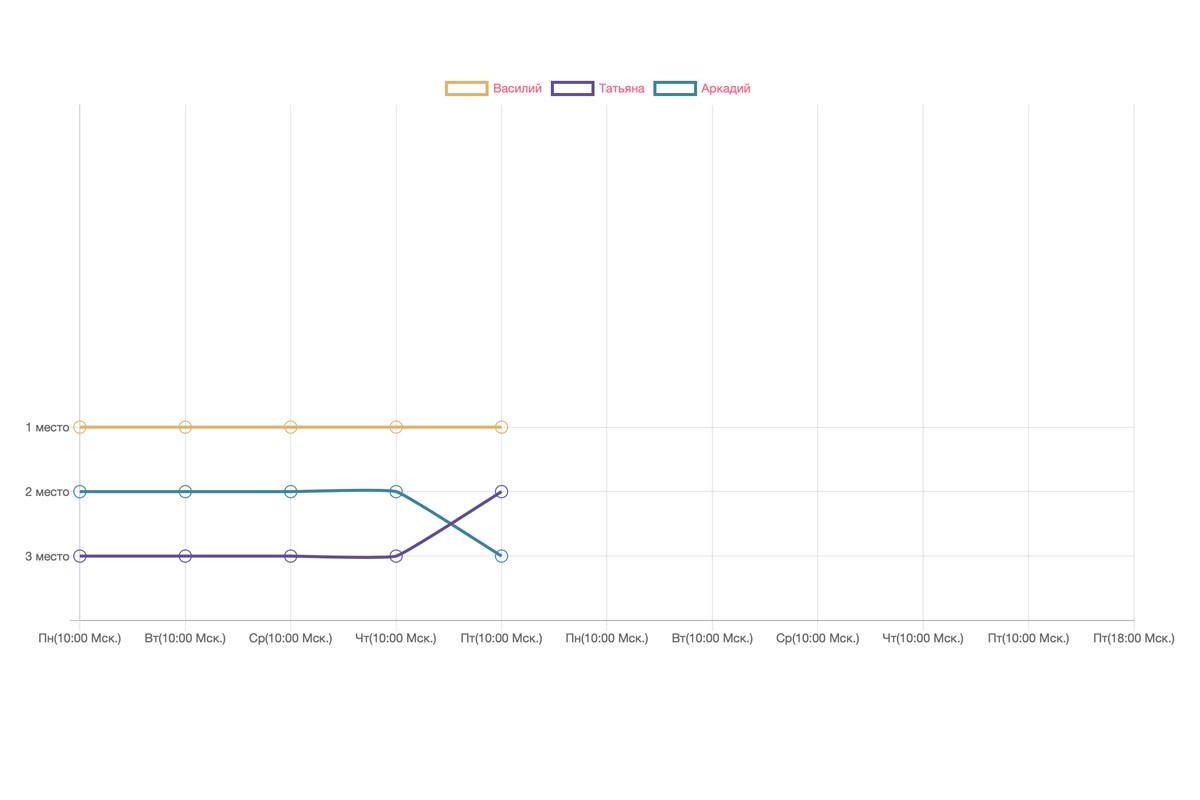
Vị trí 1: Vasily (đã đốt 23 trên 23) động thái(1->1->1->1->1)
Vị trí 2: Tatyana (đã đốt 24 trên 32) động thái(3->3->3->3->2)
Vị trí 3: Arkady (đã đốt 21 trên 29) động thái(2->2->2->2->3)
Như vậy, sử dụng chỉ số này có thể tích lũy thống kê cá nhân của từng thành viên trong nhóm và giúp họ rút ra kết luận đúng đắn. Ví dụ, ở đây chúng ta thấy rằng Vasily đã lập kế hoạch thời gian rất hợp lý ngay từ đầu (tức là khi lập kế hoạch sprint, anh ấy đã thống nhất với nhóm về khối lượng công việc mà anh ấy đã thực hiện trên thực tế.) Nhưng đồng thời, có lẽ anh ấy có thể giúp đỡ các thành viên khác trong nhóm bằng cách nào đó? Có thể là không, nhưng đáng để suy nghĩ về câu hỏi này trước buổi retrospective.
Tatyana và Arkady có vấn đề nghiêm trọng hơn. Rõ ràng là ngay từ đầu khi lập kế hoạch sprint, họ đã thống nhất với nhóm về việc tham gia vào tất cả các story và trên thực tế đã không thể hoàn thành nghĩa vụ. Cũng nên suy nghĩ về nguyên nhân trước buổi retrospective. Có thể nên lập kế hoạch ít hơn cho bản thân, có thể mở rộng năng lực để kịp hoàn thành mọi việc đã lập kế hoạch, cũng có thể có các giải pháp khác.
Như vậy, chúng ta có thể tích lũy thống kê không chỉ cho toàn bộ nhóm và không chỉ cho một sprint, mà còn cho từng thành viên cụ thể của DEV TEAM trong toàn bộ thời gian và sử dụng thông tin này để không ngừng hoàn thiện nhóm.
Tóm lại, tôi muốn đặc biệt lưu ý đến thực tế rằng trước khi sử dụng chỉ số này trong nhóm, phần lớn nhóm phải đã có mức độ tin cậy đủ cao. Ngoài ra, tôi khuyên nên nhấn mạnh nhiều vào điều quan trọng nhất - không có làm thêm giờ và hoạt động thoải mái.
Chúng tôi tập trung vào việc dự báo kết quả đúng đắn, chứ không phải vào động lực làm thêm giờ để chiếm vị trí 1. Cuối cùng, chỉ số này hướng đến việc cải thiện khả năng lập kế hoạch của từng thành viên trong nhóm một cách riêng lẻ.