
Praktijkervaring met Cumulative Flow in de context van Scrum en SAFe
In dit artikel ben ik van plan te vertellen hoe wij in de praktijk de Cumulative Flow Chart toepassen in Scrum tijdens het werken volgens het SAFe-frameworkPersoonlijke blog.
 Deze afbeelding kon niet worden geladen.
In dit artikel ben ik van plan te vertellen hoe wij in de praktijk de Cumulative Flow Chart toepassen in Scrum tijdens het werken volgens het framework SAFe
Ik begin denk ik met een link naar dit artikel - hier wordt naar mijn mening goed beschreven wat het doel ervan is in de standaardvorm, ik raad aan dit te bestuderen voor het lezen van mijn artikel. Hieronder beschrijf ik hoe wij het hebben aangepast voor het Scrum-proces (oorspronkelijk wordt het gebruikt in Kanban) en welke problemen het ons helpt op te lossen bij het werken in sprints.
Eerder heb ik in het artikel over Burn Down Charts al gezegd dat we daar het verschijnen van nieuw werk en het wegwerken van oud werk zien. Het probleem met de Burn Down Chart is dat we, in tegenstelling tot de Cumulative Flow Chart, daar de beweging van User Stories door de statussen niet zien. Wanneer we echter de bewegingen door de statussen in de Cumulative Flow Chart gaan volgen, gaan we dagelijkse veranderingen zien (de Burn Down Chart kan meerdere dagen niet veranderen en in sommige contexten kan dat heel normaal zijn) en kunnen we subtielere problemen opmerken.
Zo kan dat er in de dynamiek uitzien (op de afbeelding een diagram op basis van echte data).
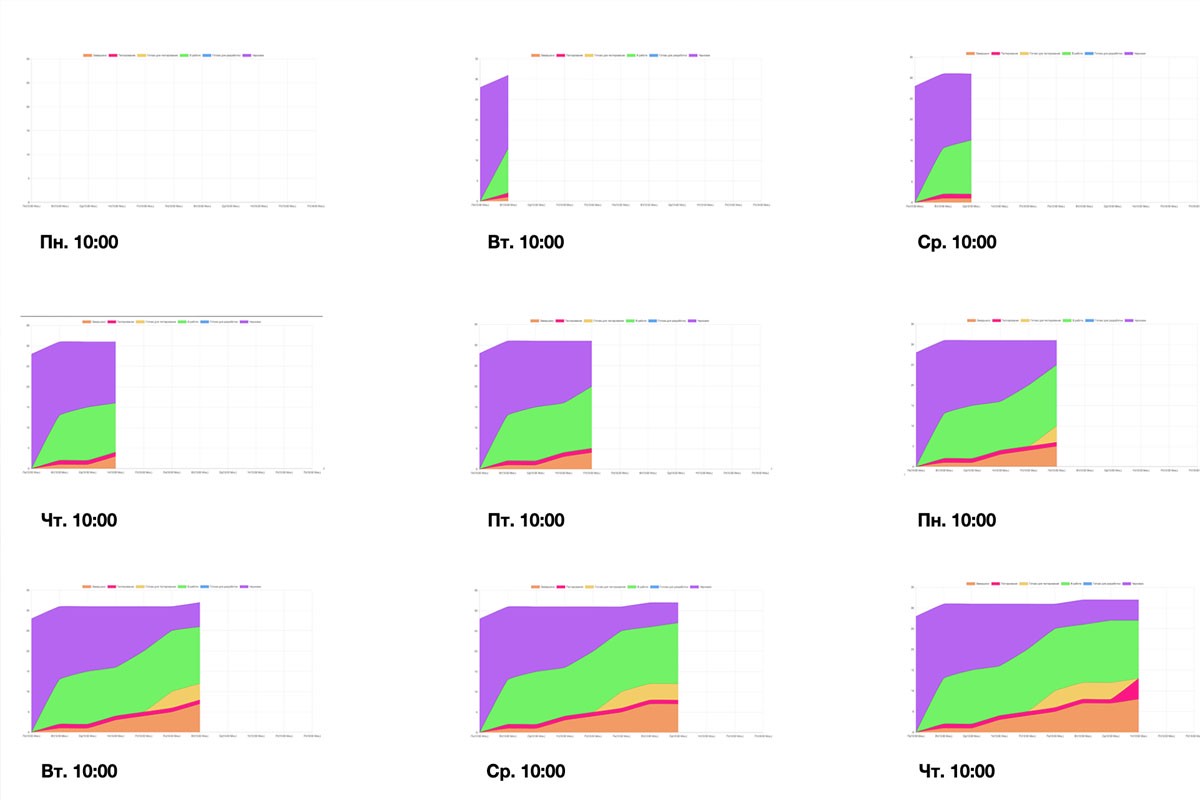
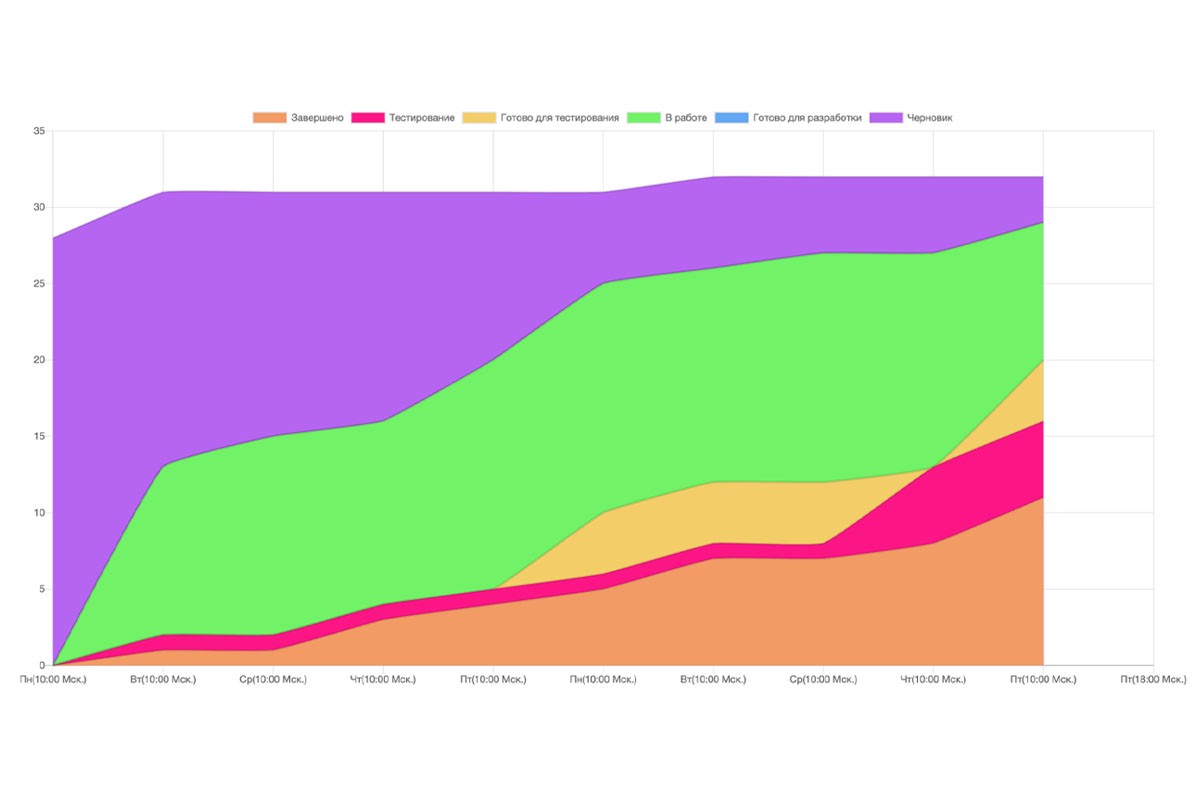
In dit voorbeeld zien we het volgende
- De eerste 7 dagen van de sprint bevindt zich zeer weinig werk in testing en het verandert niet
- Vanuit DOR (hier is dat een concept) gaan User Stories redelijk gelijkmatig naar het werk - dat is goed.
- Net als bij de Burn Down zien we dat volgens de trend de User Stories niet afgerond zullen zijn aan het einde van de sprint
Deze 3 observaties samen leiden tot de volgende conclusie. Hier had de Scrum Master al in een vroeg stadium (ergens op de tweede of derde dag van de sprint) aandacht moeten besteden aan de laag "Testing", die te klein is en te lang niet verandert (vaststellen wat de oorzaak is). Men kan veronderstellen dat het volume werk dat klaar is voor testing om welke reden dan ook niet getest kan worden, maar dan betekent dat dat de testers niets doen, en dus is het op zijn minst de moeite waard om hen aandachtiger te beluisteren op de eerstvolgende standup.
Wat de praktijk betreft: ik publiceer bijvoorbeeld dagelijks in de teamchat alle metrics voor de standup met vermelding van het hele team.
Over het algemeen moeten we niet vergeten dat metrics toch goed geïnterpreteerd moeten worden. In staat zijn om echt systemische problemen te zien als die er zijn en niet als problemen te beschouwen wat in jullie context zelfs een positief teken kan zijn