
Práctica de aplicación de Cumulative Flow en el contexto de Scrum y SAFe
En este artículo planeo contar cómo en nuestra práctica aplicamos el Cumulative Flow Chart en Scrum durante el proceso de trabajo con el framework SAFeBlog personal.
 No se pudo cargar esta imagen.
En este artículo planeo contar cómo en nuestra práctica aplicamos el Cumulative Flow Chart en Scrum durante el proceso de trabajo con el framework SAFe
Empezaré, quizás, con un enlace a este artículo - aquí, en mi opinión, se describe bien su propósito en la forma estándar, recomiendo estudiarlo antes de leer mi artículo. A continuación describiré cómo lo adaptamos para el proceso Scrum (originalmente se usa en Kanban) y qué problemas nos ayuda a resolver al trabajar por sprints.
Anteriormente, en el artículo sobre Burn Down Charts ya hablé de que allí vemos la aparición de nuevo trabajo y el agotamiento del antiguo. El problema del Burn Down Chart es que, a diferencia del Cumulative Flow Chart, en él no vemos el movimiento de las Historias de Usuario por los estados. Cuando empezamos a observar los movimientos por estados en el Cumulative Flow Chart, empezamos a ver los cambios diarios (el Burn Down Chart puede no cambiar durante varios días y en algunos contextos esto puede ser perfectamente normal) y podemos notar problemas más sutiles.
Así es como esto puede verse en dinámica (en la imagen, un diagrama construido con datos reales).
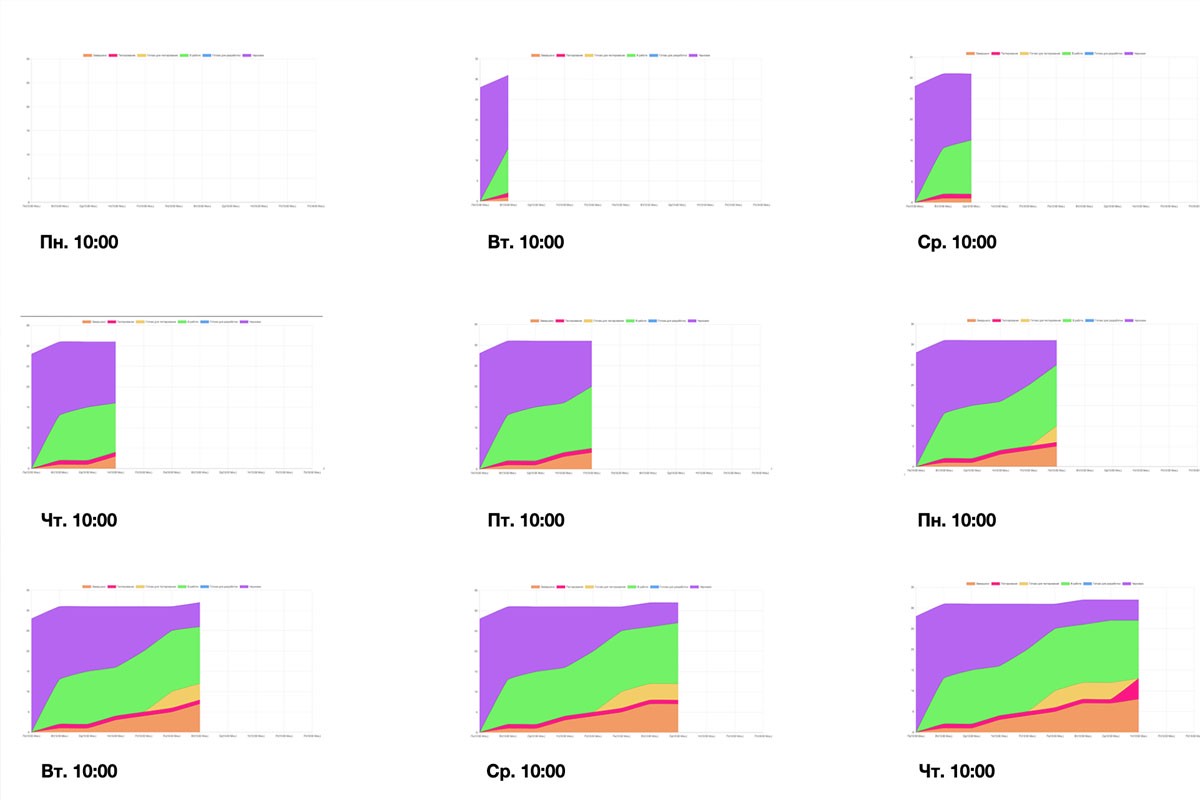
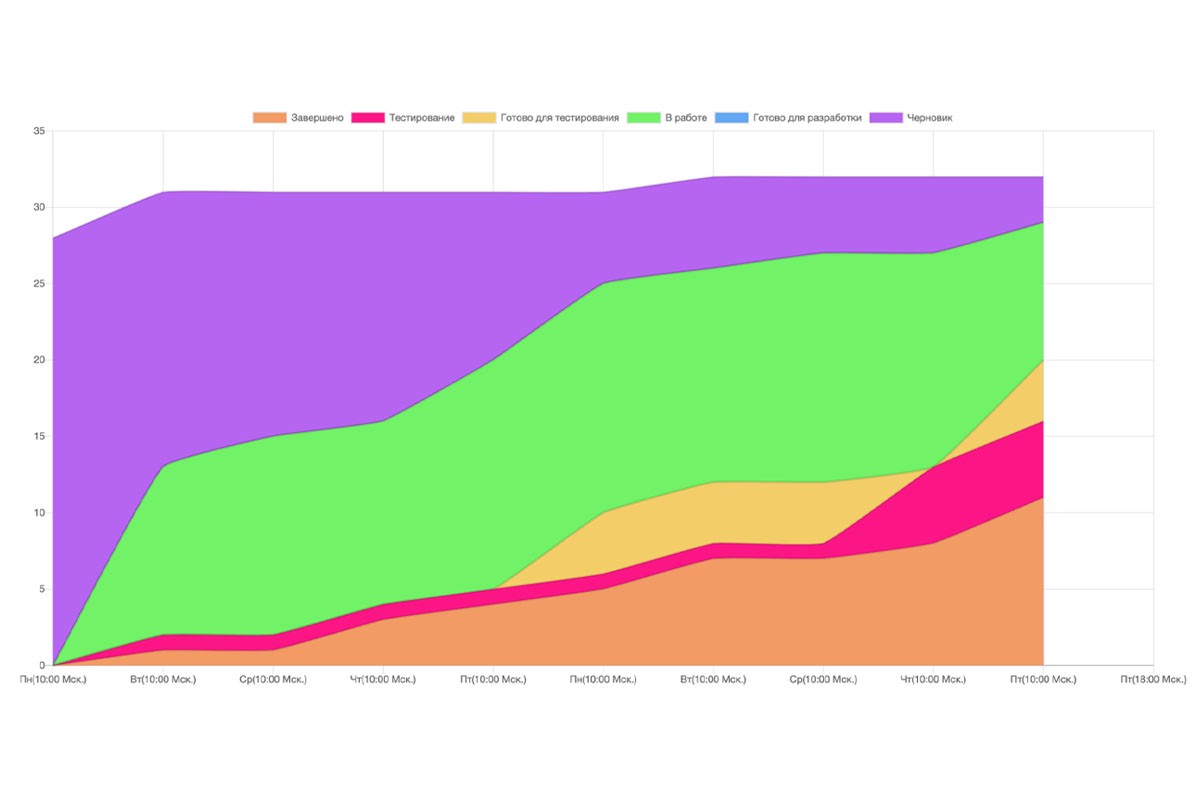
En este ejemplo vemos lo siguiente
- Los primeros 7 días del sprint hay muy poco volumen de trabajo en pruebas y no cambia
- De DOR (aquí es un borrador) las Historias de Usuario pasan al trabajo de forma bastante uniforme - esto es bueno.
- Igual que en el Burn Down, vemos que según la tendencia las Historias de Usuario no se completarán al final del sprint
Estas 3 observaciones en conjunto llevan a la siguiente conclusión. Aquí claramente ya en las etapas tempranas (en algún momento del segundo o tercer día del sprint) el Scrum Master debía haber prestado atención a la capa de "Pruebas", que es demasiado pequeña y no cambia durante bastante tiempo (averiguar cuál es la causa). Se puede suponer que el volumen de trabajo listo para pruebas no se puede probar por algunas circunstancias, pero entonces esto significa que los testers están inactivos, y por lo tanto, como mínimo, vale la pena escucharlos con más atención en el standup más cercano.
Si hablamos de la práctica de aplicación, yo, por ejemplo, publico a diario en el chat del equipo todas las métricas antes del standup mencionando a todo el equipo.
En general, no hay que olvidar que las métricas deben interpretarse correctamente. Saber ver los problemas realmente sistémicos si los hay y no percibir como problemas lo que en tu contexto puede ser incluso una señal positiva