
Практика застосування Cumulative Flow у контексті Scrum і SAFe
У цій статті я планую розповісти, як на своїй практиці ми застосовуємо Cumulative Flow Chart у Scrum у процесі роботи за фреймворком SAFeПерсональний блог.
 Не вдалося завантажити це зображення.
У цій статті я планую розповісти, як на своїй практиці ми застосовуємо Cumulative Flow Chart у Scrum у процесі роботи за фреймворком SAFe
Почну, мабуть, із посилання на таку статтю - тут, на мою думку, добре описано її призначення у стандартному вигляді, рекомендую вивчити перед прочитанням моєї статті. Нижче ж я опишу, як ми її адаптували для Scrum-процесу(спочатку вона використовується в Kanban) і які проблеми вона допомагає нам вирішувати під час роботи за спринтами.
Раніше, у статті про Burn Down Charts я вже говорив про те, що там ми бачимо появу нової роботи та згоряння старої. Проблема Burn Down Chart у тому, що, на відміну від Cumulative Flow Chart, на ній ми не бачимо рух Користувацьких Історій за статусами. Коли ж ми починаємо спостерігати рухи за статусами в Cumulative Flow Chart, ми починаємо бачити щоденні зміни (Burn Down Chart може не змінюватися кілька днів і в деяких контекстах це може бути цілком нормально) і можемо помітити тонші проблеми.
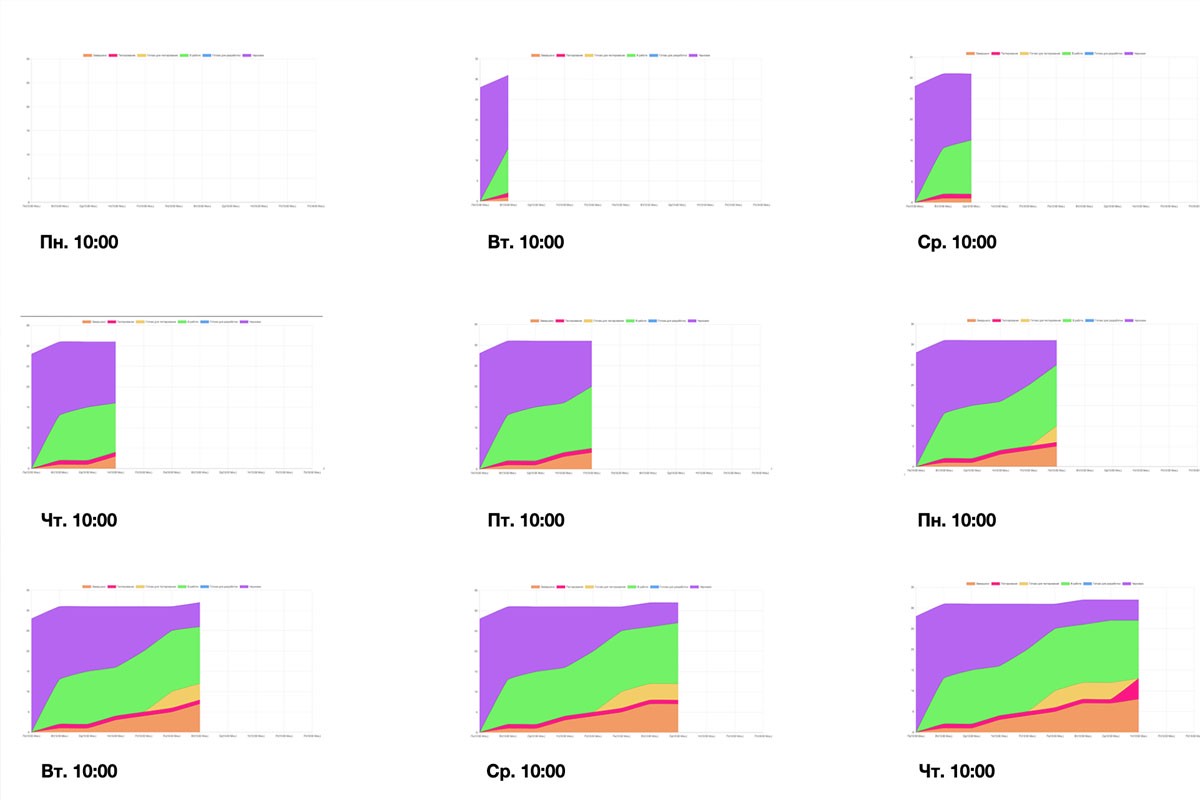
Ось як це може виглядати в динаміці(на зображенні діаграма, побудована на реальних даних).
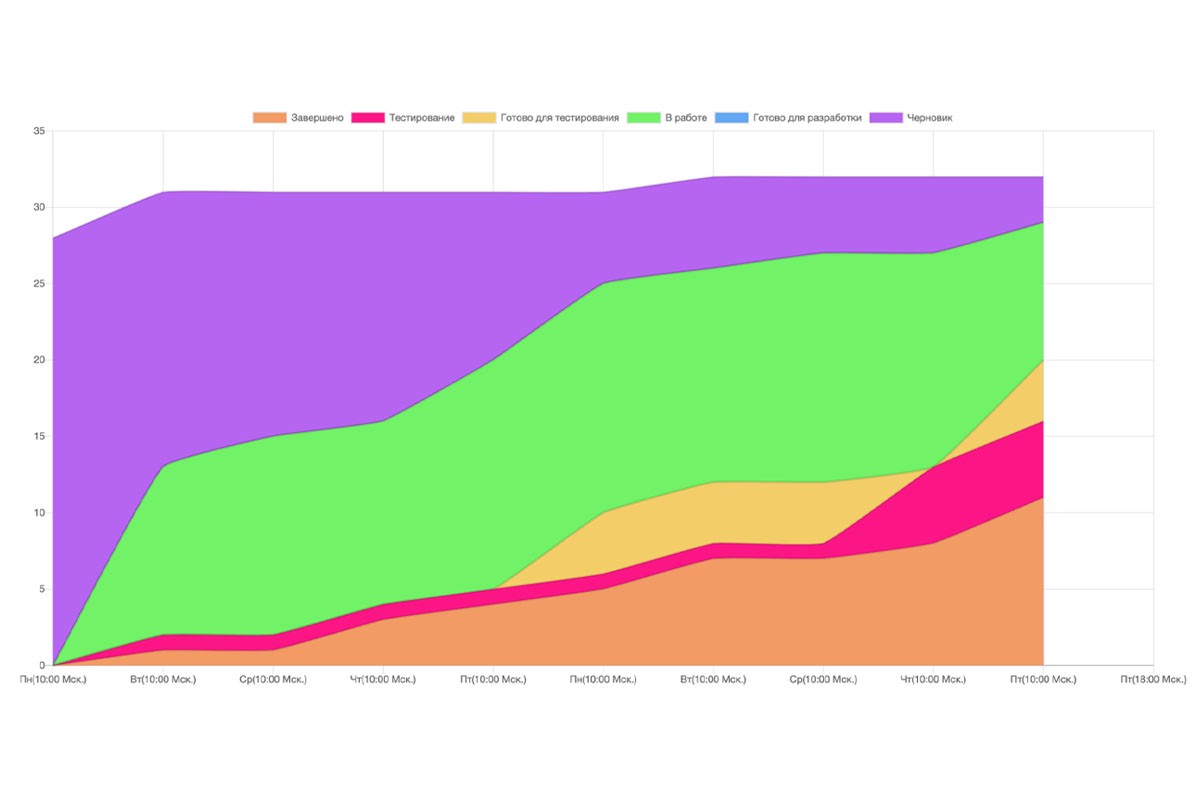
У цьому прикладі ми бачимо таке
- Перші 7 днів спринту в тестуванні перебуває дуже малий обсяг робіт і він не змінюється
- З DOR (тут це чернетка) у роботу Користувацькі Історії переходять досить рівномірно - це добре.
- Так само як і на Burn Down, ми бачимо, що згідно з тенденцією Користувацькі Історії не будуть виконані до кінця спринту
Ці 3 спостереження в сукупності приводять до такого висновку. Тут явно ще на ранніх етапах (десь на другий-третій день спринту) потрібно було Скрам Майстру звернути увагу на шар "Тестування", який занадто малий і не змінюється достатньо довго(переконатися в чому причина). Можна припустити, що обсяг роботи готової для тестування неможливо протестувати з якихось обставин, але тоді це означає, що тестувальники простоюють, а отже, як мінімум варто уважніше їх послухати на найближчому стендапі.
Якщо говорити про практику застосування, то я, наприклад, публікую щодня в чаті команди всі метрики перед стендапом зі згадуванням усієї команди.
Загалом, не варто забувати, що все ж метрики потрібно правильно інтерпретувати. Уміти бачити дійсно системні проблеми якщо вони є і не сприймати за проблеми те, що у вашому контексті може бути навіть позитивною ознакою